.jpeg)
인공지능(AI) 기반 공급망 전환과 생태계 대응성: 데이터 운영역량과 기업 간 프로세스 최적화의 순차매개효과
AI(Artificial Intelligence)-Driven Supply Chain Transformation and Ecosystem Responsiveness: The Sequential Mediating Effects of Data Operational Capability and Inter-Organizational Process Optimization
1 삼성전자 MX 사업부
1 Samsung Electronics, MX Business Division
DOI: https://doi.org/10.17287/kmr.2026.55.4.1751
초록
본 연구는 AI-Web3 투자 포트폴리오 기반 공급망 전환이 생태계 대응성에 미치는 영향과 데이터 운영역량 및 기업 간 프로세스 최적화의 역할을 실증적으로 분석하였다. 두 변수를 순차매개변수로 설정하고 분산형 데이터 거버넌스의 조절효과를 검증하기 위해 제조업 및 물류․유통 산업 종사자 136명의 자료를 SPSS, AMOS 및 PROCESS Macro Model 6으로 분석하였다. 분석 결과, AI-Web3 투자 포트폴리오는 데이터 운영역량을 향상시키고, 이는 기업 간 프로세스 최적화를 거쳐 생태계 대응성을 높이는 것으로 나타났다. 또한 데이터 운영역량과 기업 간 프로세스 최적화의 순차매개효과가 확인되었다. 반면 분산형 데이터 거버넌스의 조절효과는 유의하지 않았으나, 각 변수에 대한 직접효과는 유의하게 나타났다. 본 연구는 AI와 Web3를 통합한 투자 관점에서 디지털 기술 투자가 생태계 대응성으로 이어지는 메커니즘을 규명하였다는 점에서 의의가 있다. 또한 공급망을 상호 연결된 생태계 관점에서 조명하고, 분산형 데이터 거버넌스를 조절기제보다 데이터 공유와 협업을 지원하는 기반 환경으로 해석할 수 있는 실증적 근거를 제시하였다. 연구 결과는 디지털 전환 과정에서 기술 투자 자체보다 데이터 운영역량과 기업 간 프로세스 최적화의 강화가 중요함을 시사한다.
Abstract
This study examines the impact of AI-driven supply chain transformation on ecosystem responsiveness and investigates the roles of data operational capability and inter-organizational process optimization. Using 136 samples from manufacturing and logistics/distribution industries, the research employed SPSS, AMOS, and PROCESS Macro Models 6. The results show that the AI–Web3 investment portfolio enhances data operational capability, which promotes inter-organizational process optimization and ultimately improves ecosystem responsiveness. In addition, data operational capability and inter-organizational process optimization sequentially mediate this relationship. While the moderating effect of decentralized data governance was not significant, its direct effect was significant. This study identifies the value creation mechanism linking digital technology investments to ecosystem responsiveness and suggests that decentralized data governance serves as an enabling infrastructure for data sharing and collaboration rather than a moderating mechanism.
Ⅰ. 서 론
인공지능(AI)이 기업의 핵심 성장 동력으로 부상하면서 관련 투자와 도입은 빠르게 확대되고 있다. McKinsey(2024)는 글로벌 기업의 72%가 최소 하나 이상의 비즈니스 기능에서 AI를 활용하고 있다고 보고하였다. 그러나 AI 도입이 곧 조직 차원의 성과로 이어지는 것은 아니다. Boston Consulting Group(2024)은 별도의 글로벌 기업 조사에서 AI를 통해 실질적인 가치를 창출한 기업은 26%, 지속적으로 상당한 가치를 창출한 선도 기업은 4%에 불과한 것으로 보고하였다. 이러한 AI 도입과 성과 간의 괴리는 공급망관리(SCM) 영역에서 특히 두드러지게 나타난다. 최근 SCM 분야에서는 수요예측, 재고관리, 물류운영 등 다양한 운영 영역에서 AI 활용이 빠르게 확산되고 있으나, 이러한 활용이 실제 운영 최적화와 조직 수준의 성과로 이어지는 사례는 여전히 제한적인 것으로 보고되고 있다(Belhadi et al., 2024; Culot et al., 2024). 이는 AI 기반 분석 결과가 실제 운영 프로세스의 실행 체계와 효과적으로 연계되지 못하는 구조적 한계에서 비롯된다고 볼 수 있다.
또한 스마트팩토리와 데이터 기반 운영 시스템을 구축한 기업들조차 공급망 전반의 활동을 효과적으로 동기화하지 못해 부분적 최적화 수준에 머무르는 경우가 많다. 이러한 현상은 동일하거나 유사한 수준의 AI 역량을 보유한 기업들 사이에서도 왜 공급망 성과 차이가 크게 발생하는가라는 근본적인 질문을 제기한다.
이러한 성과 격차는 데이터와 의사결정 권한이 분산된 공급망의 구조적 특성과 관련된다. 다수의 독립적인 기업이 참여하는 공급망 네트워크에서는 참여 기업 간 조정과 거버넌스 문제가 지속적으로 발생하며(Gawer, 2014; Van Alstyne et al., 2016), 특히 데이터 단절과 상호운용성 부족, 거버넌스 메커니즘의 미비는 통합적 의사결정과 공급망 운영의 최적화를 제약하는 주요 요인으로 작용한다(Culot et al., 2024; Rai, 2016).
한편, 기존 연구들은 자원기반관점(Resource-Based View: RBV)과 동태적 역량 이론(Dynamic Capability Theory)을 기반으로 기업의 경쟁우위와 성과 창출 메커니즘을 설명해 왔으며, 최근에는 이러한 이론적 기반 위에서 기업 내부의 AI 역량이 조직 성과에 미치는 영향을 분석하고 있다(Barney, 1991; Teece, 2007). 이에 따라 SCM 분야에서도 AI와 데이터 기반 의사결정이 공급망 운영 성과와 경쟁우위에 미치는 영향을 규명하기 위한 연구가 활발히 수행되고 있다(Culot et al., 2024).
그럼에도 불구하고, 이러한 접근은 몇 가지 한계를 지닌다. 첫째, 기존 연구는 AI 및 데이터 분석 역량의 기업 내부 자원적 측면에 상대적으로 집중함으로써 데이터가 실제 운영 성과와 공급망 가치로 전환되는 과정에 대한 설명이 충분하지 않다(Dubey et al., 2019; Gupta and George, 2016). 둘째, 공급망은 본질적으로 기업 간(inter-organizational) 네트워크 구조를 가지지만, 대부분의 연구는 분석 단위를 개별 기업 수준에 한정함으로써 플랫폼 및 생태계 차원의 조정(coordination) 메커니즘과 상호의존성을 충분히 반영하지 못하고 있다(Gawer, 2014; Van Alstyne et al., 2016). 셋째, 데이터 생성과 활용이 여러 조직에 분산되어 있음에도 불구하고 데이터 통합․공유․거버넌스 문제는 상대적으로 충분히 다루어지지 않았다(Culot et al., 2024; Rai, 2016). 결과적으로 기존 이론들은 AI가 왜 공급망 성과로 일관되게 이어지지 않는지를 충분히 설명하지 못하고 있으며, 중요한 이론적 공백이 존재한다.
이러한 배경에서 본 연구는 AI 기반 성과를 단순한 ‘자원 보유(resource possession)’가 아니라 ‘전환(conversion)’의 문제로 재개념화한다. AI 투자는 데이터 운영역량을 형성할 수 있으나, 데이터의 가치는 실제 운영 프로세스와 의사결정에 활용될 때 비로소 실현된다(McAfee et al., 2012). 특히 공급망에서는 기업 간 정보 공유와 프로세스 통합을 통해 데이터가 운영 최적화로 전환될 때 그 가치가 극대화된다(Rai, 2016). 그러나 실제 기업에서는 이러한 전환이 원활하게 이루어지지 않아, 데이터 통합 및 분석 역량을 확보하더라도 이를 조직 간 운영 프로세스와 효과적으로 연계하지 못하는 경우가 많다(Culot et al., 2024).
본 연구는 이러한 문제를 해결하기 위한 핵심 메커니즘으로 Web3 기반의 분산형 데이터 거버넌스(Decentralized Data Governance)를 제안한다. 이는 블록체인 기반의 신뢰 메커니즘(Nakamoto, 2008), 스마트계약 기반 자동화(Szabo, 1997), 그리고 토큰 기반 인센티브 구조(Buterin, 2014)를 활용하여 공급망에서 발생하는 신뢰 부족, 거버넌스 문제, 인센티브 불일치와 같은 구조적 제약을 완화할 수 있다.
이러한 논리를 바탕으로 본 연구는 AI-Web3 투자 포트폴리오가 데이터 운영역량을 향상시키고, 이는 다시 기업 간 프로세스 최적화로 전환되며, 궁극적으로 생태계 대응성으로 이어지는 전환 기반 연구모형을 제안한다. 또한 본 연구는 분산형 데이터 거버넌스가 조직 간 데이터 공유와 조정 메커니즘에 영향을 미침으로써, 주요 변수 간 관계에 중요한 역할을 수행할 가능성에 주목한다.
본 연구의 학술적 기여는 다음과 같다. 첫째, AI와 SCM 연구에서 기존의 기업 수준 자원 중심 관점을 넘어, 데이터가 실제 운영 성과로 전환되는 과정 자체에 주목하였다. 둘째, 공급망을 상호 연결된 네트워크로 재개념화하고, 데이터의 분산성과 기업 간 상호의존성을 연구모형에 반영하였다. 셋째, Web3 기반 분산형 데이터 거버넌스를 단순한 기술이 아니라 데이터 - 프로세스 전환을 가능하게 하는 거버넌스 메커니즘으로 제시하였다. 마지막으로 AI 투자 → 데이터 역량 → 프로세스 최적화 → 생태계 대응성으로 이어지는 단계적 전환 프레임워크를 제안함으로써 기존의 선형적 AI 성과 관점을 확장하였다.
이러한 연구 목적과 기여를 바탕으로 본 논문은 다음과 같이 구성된다. 제Ⅰ장 서론에 이어, 제Ⅱ장에서는 이론적 배경을 검토하고 이를 바탕으로 제Ⅲ장에서는 연구 가설을 제시한다. 제Ⅳ장에서는 연구 설계와 조사 방법을 설명하며, 제Ⅴ장에서는 실증 분석을 통해 연구 가설을 검증한다. 마지막으로 제Ⅵ장에서는 본 연구의 시사점을 논의하고, 연구 한계 및 향후 연구 방향을 제시한다.
Ⅱ. 이론적 배경
2.1 AI-Web3 투자 포트폴리오
자원기반관점은 기업의 성과가 단순한 기술 도입 자체가 아니라, VRIN1) 자원의 체계적 결합에 의해 결정된다고 설명한다(Barney, 1991). 이러한 관점을 디지털 환경으로 확장한 연구들은 기술의 가치가 개별 기술 투자 자체에서 발생하는 것이 아니라, IT 인프라, 인적 자원, 조직적 무형자산 등 다양한 자원의 통합을 통해 실현된다고 주장한다(Bharadwaj, 2000). 따라서 AI와 같은 기술적 투자는 개별적 투입 요소라기보다, 조직역량 형성을 지원하는 보다 광범위한 자원 시스템의 구성 요소로 이해될 필요가 있다.
이와 함께 후속 연구들은 단순한 자원 보유나 통합만으로는 지속적인 가치 창출이 어렵다는 점을 강조한다. 기업은 자원을 구조화(structuring)하고, 이를 결합(bundling)하여 조직역량으로 발전시킨 뒤, 활용(leveraging)하는 관리적 활동을 통해 비로소 자원의 잠재적 가치를 실질적인 경쟁우위로 전환할 수 있다(Sirmon et al., 2007). 나아가 자원 조율(resource orchestration)은 이러한 일련의 관리 활동을 통해 기업 간 성과 차이를 설명하는 핵심 메커니즘으로 제시된다(Sirmon et al., 2011). 따라서 동일한 AI 기술을 도입하더라도 자원을 어떻게 조율하고 활용하느냐에 따라 성과는 상이하게 나타날 수 있다.
실제로 AI 및 데이터 인프라와 같은 기술적 자원은 기업 성과에 직접적으로 영향을 미치기보다는, 데이터 활용역량이나 운영역량과 같은 중간 수준의 역량(intermediate capability)을 매개로 간접적인 가치가 실현된다(Mikalef et al., 2020). 이는 데이터 자체의 보유보다 데이터를 조직의 운영 프로세스 및 의사결정 과정에 효과적으로 통합하고 활용할 수 있는 역량이 중요함을 시사한다(Ghafoori et al., 2024; McAfee et al., 2012).
특히 최근의 공급망 및 디지털 생태계 환경에서는 기업 내부의 데이터 활용을 넘어 조직 간 데이터 공유와 협업 프로세스를 지원할 수 있는 디지털 인프라의 중요성이 더욱 강조되고 있다. AI 기반 운영체계는 데이터 분석과 예측 정확도를 향상시키지만, 데이터가 조직 경계를 넘어 안전하게 교환․연계․활용되기 위해서는 이를 지원하는 추가적인 기술적 기반이 필요하다(Culot et al., 2024; Rai, 2016).
이러한 맥락에서 블록체인과 같은 Web3 기반 분산형 기술은 조직 간 데이터 기록, 저장, 공유 및 연계를 지원하는 새로운 디지털 인프라로 주목받고 있다(Beck et al., 2018; Gans, 2016; Tapscott and Tapscott, 2016). Web3 기술은 분산원장, 스마트계약, 토큰 기반 네트워크 등을 통해 참여 조직들이 공통의 디지털 환경에서 상호 연결될 수 있도록 지원하며(Babich and Hilary, 2020; Saberi et al., 2019), AI 기반 데이터 활용의 범위를 조직 내부에서 생태계 수준으로 확장할 수 있는 기술적 기반을 제공한다.
이러한 논의를 종합하면, 디지털 전환 환경에서 경쟁우위는 개별 기술의 도입 수준보다 AI, 데이터, Web3 관련 자원과 인적․조직 자원이 전략적으로 결합되고 조율될 때 더욱 강화될 수 있다. 이에 본 연구는 AI-Web3 투자 포트폴리오를 데이터 기반 운영과 조직 간 디지털 협업을 지원하는 통합적 자원 체계로 개념화하였다.
구체적으로 AI-Web3 투자 포트폴리오는 네 가지 구성요소로 이루어진다. 첫째, AI 기술 인프라 자원은 클라우드 기반 컴퓨팅 환경, AI 기반 의사결정 지원 시스템, 생성형 AI 및 AI 에이전트를 포함한 기업 특화 AI 모델의 개발․배포․운영과 성능 관리 등을 포함하며, 데이터 분석, 업무 프로세스 자동화 및 운영 의사결정을 지원한다(Bharadwaj, 2000; Mikalef et al., 2020; Sculley et al., 2015). 본 연구에서는 이러한 AI 기술 인프라 중 데이터 운영역량의 형성과 활용을 지원하는 AI 기술 및 디지털 인프라에 대한 투자에 초점을 둔다. 둘째, 데이터 인프라 자원은 운영 데이터의 수집․통합․저장․품질관리를 위한 기술적 기반을 의미한다. 이는 조직 내 분산된 데이터를 체계적으로 관리하고 데이터의 정확성, 접근성 및 활용 가능성을 향상시킴으로써 데이터 기반 운영 활동을 지원한다(Gupta and George, 2016; Khatri and Brown, 2010; McAfee et al., 2012; Wang and Strong, 1996). 셋째, Web3 분산형 인프라 자원은 블록체인 네트워크, 분산원장 시스템, 스마트계약 실행 환경, 그리고 Web3 기반 데이터 교환 플랫폼 등으로 구성된 기술적 기반을 의미한다. 이러한 인프라는 조직 간 데이터의 기록․저장․전송․공유를 지원하며, 분산형 데이터 활용과 협업이 가능한 디지털 운영 환경을 제공한다(Babich and Hilary, 2020; Beck et al., 2018; Saberi et al., 2019; Tapscott and Tapscott, 2016). 중요한 점은 Web3 인프라가 조직 간 상호작용을 직접 규율하는 거버넌스 메커니즘 자체라기보다, 향후 분산형 데이터 거버넌스가 구현될 수 있는 기술적 토대를 제공한다는 점이다. 넷째, 인적․조직 자원은 AI 및 데이터 활용을 지원하는 전문 인력, 조직 학습, 교육․훈련 및 역량 개발 체계를 포함한다. 이러한 자원은 기술 및 데이터 자원을 실제 운영 활동과 조직 가치 창출로 연결하는 역할을 수행하며, 디지털 전환의 실행 가능성을 결정하는 핵심 기반으로 작용한다(Ghafoori et al., 2024; Kane et al., 2015; Mikalef et al., 2019a).
중요한 점은 이러한 자원들이 독립적으로 작동하기보다 상호 연계되고 보완적으로 결합될 때 가치가 창출된다는 점이다. AI 기술 인프라는 데이터 분석과 예측을 지원하고, 데이터 인프라는 신뢰성 있는 데이터 자산을 제공하며, Web3 인프라는 조직 간 데이터 공유와 협업을 위한 디지털 환경을 제공한다. 또한 인적․조직 자원은 이러한 기술과 데이터를 실제 운영과 의사결정에 효과적으로 활용할 수 있도록 지원한다. 따라서 AI-Web3 투자 포트폴리오는 개별 기술의 도입 수준보다 다양한 자원의 전략적 정렬과 통합을 통해 후속 역량의 형성을 가능하게 하는 자원 기반(resource base)으로 이해될 수 있다(Sirmon et al., 2007; Sirmon et al., 2011).
이에 본 연구는 AI-Web3 투자 포트폴리오를 기업이 AI 기반 디지털 전환과 공급망 생태계 혁신을 위해 전략적으로 구축하는 투자자원의 집합(resource portfolio)으로 정의한다. 이는 단순한 데이터 활용 기술에 대한 투자를 넘어 AI 컴퓨팅 인프라, 데이터 인프 라, Web3 기반 분산형 인프라, 그리고 이를 활용할 수 있는 인적․조직 자원까지 포함하는 통합적 투자체계를 의미한다.
이러한 투자 포트폴리오는 기업 성과를 직접 창출하는 조직역량(capability)이 아니라, 다양한 AI 활용과 후속 조직역량의 형성을 가능하게 하는 전략적 자원 기반(resource base)으로 이해된다. 이러한 관점은 동일한 AI 기술 투자 수준에서도 기업 간 운영 성과와 디지털 전환 성과가 상이하게 나타나는 이유를 설명하며, AI 투자의 효과가 후속 조직역량을 통해 실현된다는 본 연구의 이론적 논리를 뒷받침한다.
2.2 데이터 운영역량
빅데이터 분석 기술의 확산으로 많은 기업들이 데이터 인프라와 분석 시스템에 대규모 투자를 진행하고 있다. 그러나 선행연구들은 이러한 투자 자체만으로는 경쟁우위가 보장되지 않으며, 데이터와 기술 자원을 조직 차원의 분석․운영 역량으로 전환할 때 비로소 가치가 창출된다고 지적한다(Gupta and George, 2016; Mikalef et al., 2018; 김경철, 2026).
이러한 관점에서 데이터 운영역량은 AI-Web3 투자 포트폴리오와 구별되는 조직역량이다. AI-Web3 투자 포트폴리오가 AI 기반 디지털 전환을 위한 기술적․조직적 투자자원의 집합이라면, 데이터 운영역량은 이러한 투자자원을 실제 운영 과정에서 통합․관리․활용함으로써 형성되는 실행 중심의 조직역량(capability)을 의미한다. 즉, 투자자원(resource)은 조직역량(capability)의 선행요인으로 작용하며, 데이터 운영역량은 투자자원이 운영 프로세스에 내재화되는 과정에서 형성되는 중간 수준의 조직역량으로 이해할 수 있다(Gupta and George, 2016; Sirmon et al., 2007).
데이터 운영역량은 데이터 및 IT 인프라, 인적 전문성, 데이터 기반 조직문화 등 다양한 자원이 유기적으로 결합되어 형성된다(Gupta and George, 2016). 그러나 성과는 자원의 단순한 보유보다 조직 내에서 효과적으로 정렬되고 상호작용하는 정도에 의해 결정된다(Mikalef et al., 2018). 따라서 데이터와 분석 도구를 실제 운영 프로세스에 내재화하여 조직 차원의 실행역량으로 전환하는 과정이 중요하다.
최근 연구들은 데이터 역량이 상위 수준의 동태적 역량 형성에도 기여함을 보여준다. 예를 들어, 빅데이터 분석 역량은 기업의 데이터 기반 인사이트 창출 능력을 강화하고, 이는 변화 감지(sensing), 기회 포착(seizing), 자원 재구성(reconfiguring) 역량 강화로 이어진다(Mikalef et al., 2019b). 또한 환경의 불확실성과 복잡성이 높을수록 이러한 효과는 더욱 강화되는데, 이는 데이터 역량의 가치가 변화하는 환경에 대한 적응 능력에 달려 있음을 시사한다.
나아가 데이터 분석 역량의 효과는 대부분 직접적이라기보다 간접적으로 나타난다. 데이터와 분석 결과는 그 자체로 성과를 창출하기보다 실제 운영 프로세스와 조직적 실행에 반영될 때 비로소 가치가 실현된다(Mikalef et al., 2019a; Wamba et al., 2017). 이 과정에서 프로세스 기반의 동태적 역량은 데이터 기반 인사이트를 운영 개선 활동과 의사결정 체계에 효과적으로 통합하는 핵심 메커니즘으로 작용한다(Mikalef et al., 2019b; Wamba et al., 2017). 이를 통해 도출된 인사이트는 업무 프로세스와 지속적 개선 활동 전반에 내재화될 수 있다.
마찬가지로, 비즈니스 인텔리전스(BI) 및 데이터 분석 활용 연구들도 데이터 역량의 가치가 실제 운영 및 의사결정 과정에서의 활용을 통해 실현된다는 점을 강조한다. 기업은 분석 결과를 조직의 의사결정 및 혁신 프로세스에 체계적으로 반영할 때 데이터로부터 실질적 가치를 창출할 수 있다(Božič and Dimovski, 2019; Chen et al., 2012; LaValle et al., 2011). 즉, 데이터 활용이 일회성 분석 활동이 아니라 반복적이고 일상적인 운영 루틴으로 정착될 때 데이터 역량은 조직 전체의 운영 체계로 확장될 수 있다. 이러한 데이터 기반 운영 체계는 조직이 운영 프로세스를 지속적으로 모니터링하고 최적화할 수 있는 기반을 제공한다.
이와 관련하여, 기업은 실시간 및 관측 데이터를 활용하여 운영 과정에 직접 개입하거나 높은 비용이 수반되는 통제 실험2)을 하는 대신, 실제 운영 데이터를 기반으로 운영 프로세스를 지속적으로 개선하는 적응적 운영 관리3)를 수행할 수 있다(McAfee et al., 2012; Sadati et al., 2018). 이러한 과정에서 데이터는 단순한 정보 자산을 넘어 운영 실행과 지속적 개선을 지원하는 핵심 자원으로 기능한다.
특히 이러한 데이터 기반 운영의 효과성은 데이터 품질과 관리 수준에 크게 의존한다. 정확성, 완전성, 일관성, 적시성을 갖춘 고품질 데이터는 신뢰성 있는 분석과 의사결정의 핵심 기반이다(Peixoto et al., 2025). 아울러 데이터 관리 체계는 데이터 관리 권한과 책임, 접근 통제 및 활용 기준을 명확히 함으로써 조직 전반의 데이터 활용을 안정적으로 지원한다(Khatri and Brown, 2010). 이러한 기반이 부족할 경우 고도화된 분석 기술을 보유하더라도 실질적 운영 성과로 연결되기 어렵다.
이러한 논의를 종합하면, 데이터 기반 운영은 단순한 데이터 자산이나 기술 인프라를 넘어 자원 - 실행 - 적응을 연결하는 실행 중심의 운영역량으로 이해될 필요가 있다. 이에 본 연구는 데이터 운영역량을 조직이 데이터를 통합․관리․활용함으로써 운영 프로세스를 일관되고 유기적으로 실행할 수 있게 하는 역량으로 개념화하였다.
구체적으로 데이터 운영역량은 세 가지 구성요소로 이루어진다. 첫째, 데이터 통합 역량은 이질적인 운영 데이터를 연결하고 표준화된 구조로 통합함으로써 조직 내 기능 간 원활한 데이터 흐름을 가능하게 하는 역량이다(Ghahramani et al., 2020; Gupta and George, 2016). 둘째, 데이터 품질 및 관리 역량은 데이터의 정확성․일관성․신뢰성을 확보하고 데이터 관리 권한과 접근 통제 체계를 운영하는 역량을 의미한다(Khatri and Brown, 2010; Peixoto et al., 2025; Wang and Strong, 1996; Weill and Ross, 2004). 셋째, 데이터 활용역량은 분석 결과를 운영 의사결정과 실행 프로세스에 내재화하고, 이를 표준화된 운영 루틴과 지속적 개선 활동으로 연결하는 역량을 의미한다(Božič and Dimovski, 2019; LaValle et al., 2011; Mikalef et al., 2019a; Wamba et al., 2017).
데이터 운영역량의 핵심 가치는 데이터 자체나 분석도구의 보유가 아니라, 이를 효과적으로 통합․관리․활용하여 반복 가능하고 확장 가능한 운영 프로세스로 내재화하는 데 있다. 이러한 데이터 운영역량은 AI-Web3 투자 포트폴리오를 실제 운영 성과로 연결하는 핵심 실행역량으로 기능하며, 후속 기업 간 프로세스 최적화와 생태계 대응성의 기반이 된다.
2.3 기업 간 프로세스 최적화
공급망관리(SCM) 관점에서 기업 간 성과는 단순한 협력 관계의 형성 여부보다 조직 간 프로세스가 얼마나 구조적으로 정렬되고 통합적으로 운영되는가에 의해 결정된다(Flynn et al., 2010; Schoenherr and Swink, 2012). 이러한 맥락에서 공급망 통합(supply chain integration)은 제품․정보․자금․의사결정 흐름을 효과적으로 관리하기 위해 기업 내․외부 프로세스를 유기적으로 연계하고 통합적으로 운영하는 수준으로 정의된다(Flynn et al., 2010). 특히 내부 통합이 미흡하거나 조직 간 연계 수준이 불균형할 경우 공급망 성과는 일관되게 나타나지 않으며, 이는 공급망 통합이 단순한 관계적 특성이 아니라 조직 간 프로세스의 구조적 정렬과 동기화를 구현하는 실행 메커니즘임을 시사한다(Schoenherr and Swink, 2012; Swink et al., 2007).
이러한 조직 간 통합을 지원하는 중요한 기반 요소 중 하나는 디지털 및 IT 인프라이다. IT 기반 통합 연구에 따르면, 통합된 디지털 인프라는 실시간 정보 공유, 공동 계획 수립, 그리고 공급망 참여자 간 상호의존적 활동의 조정(coordination)을 가능하게 한다(Rai et al., 2006). 또한 IT 기반 프로세스 혁신은 조직 간 단절된 업무 흐름을 연결함으로써 end-to-end 프로세스 최적화를 지원하며(Davenport, 1993), 기업 간 시스템 연계와 관계특화 투자(relation-specific investment)4)를 통해 협업 프로세스와 공동 업무 수행 체계를 강화한다(Subramani, 2004). 즉, 조직 간 공동 가치 창출의 핵심은 기술 자체보다 이를 기반으로 한 프로세스 연계와 협업 운영 체계에 있다. 따라서 디지털 기술의 가치는 조직 간 공동 실행을 가능하게 하는 프로세스 구조와 결합될 때 비로소 실현된다.
특히 조직 간 실행 조정의 수준은 정보 흐름의 품질과 투명성에 크게 좌우된다. 공급망 내 정보 왜곡은 수요 및 재고 변동성을 증폭시키고 비효율적인 의사결정을 초래하는 반면, 정보 공유와 가시성의 향상은 조정의 정확도를 높이고 불확실성을 완화한다(Lee et al., 1997; Wiengarten et al., 2013). 이는 추적 가능성(traceability), 가시성(visibility), 그리고 표준화된 정보 교환 구조가 효과적인 기업 간 프로세스 운영의 핵심 기반임을 보여준다.
나아가, 데이터 기반 운영 환경에서는 분석 및 의사결정 역량이 조직 간 조정 메커니즘과 결합될 때 비로소 실제 공동 실행으로 연결될 수 있다(Srinivasan and Swink, 2018). 최근의 데이터 중심 아키텍처와 AI 기반 운영 환경은 이러한 조직 간 실행 구조를 더욱 고도화하고 있다. 실시간 데이터 공유와 예측 기반 운영은 기업 내부의 실행 역량을 공급망 네트워크 수준의 공동 운영 체계로 확장시키며(Mudgal, 2025), 이를 통해 조직 간 프로세스는 보다 투명하고 정렬된 방식으로 운영될 수 있다. 이처럼 디지털 전환과 AI 기반 역량은 공급망 통합을 통해 기업 성과에 영향을 미치며(Jing and Fan, 2024; Ma and Chang, 2025), 성과 창출을 위해서는 조직 간 정보 공유와 운영 조정이 필수적이다.
이러한 논의를 종합하면, 기업 간 프로세스 최적화는 연결된 조직들이 데이터를 기반으로 운영 프로세스를 공동 조정하고 실행함으로써 공급망 수준의 실행 효율성과 운영 일관성을 구현하는 역량으로 이해될 수 있다. 이에 본 연구는 기업 간 프로세스 최적화를 데이터 기반 역량이 조직 간 공동 실행으로 전환되는 핵심 운영 메커니즘으로 개념화하였다.
구체적으로 기업 간 프로세스 최적화는 세 가지 구성요소로 이루어진다. 첫째, 정보 흐름(information flow)은 외부 파트너와의 운영 데이터 공유, 통합 및 자동화된 정보 교환 수준을 의미하며, 이를 통해 조직 간 실시간 정보 연계와 공동 계획 수립을 가능하게 한다(Lee et al., 1997; Rai et al., 2006). 둘째, 프로세스 연계(process linkage)는 외부 파트너와 운영 프로세스를 체계적으로 연결하고 공동 운영과 협업적 의사결정을 수행하는 수준을 의미하며, 이를 통해 동기화된 워크플로우와 조직 간 프로세스 통합을 가능하게 한다(Davenport, 1993; Subramani, 2004; Swink et al., 2007). 셋째, 추적 가능성과 가시성(traceability and visibility)은 실시간 운영 모니터링과 end-to-end 운영 투명성을 통해 문제 원인을 신속히 파악하고 불확실성 상황에서 효과적인 조정을 가능하게 하는 수준을 의미한다(Saberi et al., 2019; Srinivasan and Swink, 2018; Wiengarten et al., 2013).
중요한 점은 기업 간 프로세스 최적화가 단순한 관계적 협력 수준이 아니라, 내부 데이터 역량을 조직 간 공동 실행으로 전환하는 구조적 실행 메커니즘이라는 점이다. 즉, 기업 간 프로세스 최적화는 데이터 기반 역량을 조직 간 공동 실행으로 연결하여 공급망 수준의 운영 성과를 실현하는 핵심 실행 메커니즘으로 기능한다.
2.4 생태계 대응성
디지털 전환과 동태적 역량에 관한 선행 연구는 급변하는 환경에서 기업 성과가 단순한 정적인 자원의 보유가 아니라, 환경 변화를 감지하고 대응하며 적응할 수 있는 조직역량에 의해 결정된다는 점을 일관되게 제시한다(Eisenhardt and Martin, 2000; Sambamurthy et al., 2003; Teece et al., 1997). 특히 IT 투자와 디지털 역량은 민첩성(agility), 디지털 옵션(digital options), 기업가적 경계성(alertness)과 같은 조직역량을 매개로 기업 성과에 간접적으로 영향을 미치며, 이를 통해 기업은 신속하고 조정된 경쟁 행동을 수행할 수 있게 된다(Lee et al., 2015; Sambamurthy et al., 2003). 즉, 급변하는 환경에서 경쟁우위를 결정하는 핵심은 자원 자체보다 환경 변화에 대해 신속하고 조정된 방식으로 대응할 수 있는 조직의 대응성에 있다(Eisenhardt and Martin, 2000; Sambamurthy et al., 2003).
여기서 대응성(responsiveness)은 단순한 반응 속도나 운영 민첩성에 국한되지 않으며, 환경 변화의 감지와 기회 포착, 조직 간 조정, 적응적 실행 및 자원 재구성을 포괄하는 동태적 역량으로 이해될 필요가 있다(Pavlou and El Sawy, 2011; Teece, 2007). 동태적 역량 관점에서 조직은 환경 변화와 새로운 기회를 신속하게 감지할 뿐 아니라, 이를 조직 내․외부의 조정된 대응 행동으로 연결하여 변화하는 환경과의 정렬을 지속적으로 유지해야 한다(Overby et al., 2006; Roberts and Grover, 2012; Teece, 2007). 이러한 특성은 다수의 참여자가 상호의존적으로 협력하는 공급망 및 디지털 생태계 환경에서 더욱 중요하게 작용한다.
한편, 본 연구의 생태계 대응성(ecosystem responsiveness)은 민첩성(agility), 회복탄력성(resilience), 적응성(adaptability)이 각각 강조하는 신속한 대응, 운영 회복 및 구조적 재구성의 핵심 행동 특성을 생태계 참여자 간 조정(coordination)과 협업(collaboration)을 통한 공동 대응의 관점에서 통합한 개념이다(Adner, 2017; Pavlou and El Sawy, 2011; Teece, 2007). 민첩성은 변화에 대한 신속한 대응을, 회복탄력성은 외부 충격 이후의 운영 회복을, 적응성은 환경 변화에 따른 구조적 재구성을 각각 강조하는 반면(Ambulkar et al., 2015; Overby et al., 2006; Teece et al., 2016; Wieland and Wallenburg, 2013), 생태계 대응성은 이러한 역량이 참여자 간 공동의 감지, 의사결정, 협업적 실행, 그리고 적응과 회복을 통해 발현되는 생태계 수준의 대응역량에 초점을 둔다.
이러한 논의를 종합하면, 공급망과 같이 참여자 간 상호의존성이 높은 환경에서 대응성은 개별 기업의 신속한 대응을 넘어 참여자들이 공동으로 환경 변화와 운영 리스크를 감지하고, 조직 간 의사결정을 조율하며, 협업적으로 적응하고 회복하는 생태계 차원의 역량으로 이해될 수 있다. 이에 본 연구는 생태계 대응성을 상호의존적 참여자들이 환경 변화와 운영 리스크, 그리고 새로운 기회를 공동으로 감지하고, 조직 간 의사결정을 조율하며, 협업적 실행과 적응․회복 활동을 수행할 수 있게 하는 생태계 차원의 동태적 역량으로 개념화하였다.
구체적으로 생태계 대응성은 네 가지 구성요소로 이루어진다. 첫째, 대응 속도(response speed)는 수요 변화, 공급 차질, 예외 상황 발생 시 운영 실행을 신속하게 조정하고 의사결정을 빠르게 수행할 수 있는 능력을 의미한다(Overby et al., 2006; Roberts and Grover, 2012). 둘째, 협업적 문제 해결(collaborative problem solving)은 운영상 문제를 외부 파트너와 공동으로 식별하고 원인을 공유하며 해결책을 함께 실행하는 능력을 의미한다(Pavlou and El Sawy, 2011; Sambamurthy et al., 2003). 셋째, 적응 및 재구성(adaptation and reconfiguration)은 환경 변화에 따라 운영 정책과 프로세스를 유연하게 조정하고, 장기적 구조 변화에 맞추어 조직 구조와 네트워크를 재편할 수 있는 능력을 의미한다(Eisenhardt and Martin, 2000; Teece, 2007). 넷째, 회복탄력성(resilience)은 위기 상황에서도 운영을 지속하고 외부 파트너와 협력하여 정상 상태 혹은 개선된 상태로 회복할 수 있는 능력을 의미한다(Ambulkar et al., 2015; Wieland and Wallenburg, 2013).
이들 구성요소는 상호 보완적으로 작동하며, 환경 변화에 대한 공동의 감지와 대응, 적응 및 회복을 가능하게 한다. 따라서 생태계 대응성은 데이터 기반 인사이트를 생태계 수준의 협업적․적응적 실행으로 전환하는 핵심 역량으로 이해될 수 있다.
개념적으로 생태계 대응성은 기업 간 프로세스 최적화와 구별된다. 기업 간 프로세스 최적화가 조직 간 실행 프로세스의 구조적 정렬과 통합 수준을 의미한다면, 생태계 대응성은 이러한 기반 위에서 다수의 참여자가 환경 변화에 공동으로 대응하고 적응하는 행동적․동태적 결과를 의미한다. 즉, 기업 간 프로세스 최적화가 실행 인프라라면, 생태계 대응성은 그 인프라를 바탕으로 발현되는 생태계 수준의 대응역량이라 할 수 있다.
2.5 분산형 데이터 거버넌스
블록체인과 Web3 기술은 조직 간 거래와 협업에서 신뢰, 조정, 그리고 거버넌스가 형성되는 메커니즘 자체를 변화시키고 있다(Beck et al., 2018; Nakamoto, 2008). 초기 블록체인 연구들은 분산형 시스템이 중앙집중형 중개기관 없이도 합의 메커니즘과 암호학적 검증을 기반으로 신뢰 가능한 거래 기록과 데이터 공유를 가능하게 함을 제시하였다(Nakamoto, 2008). 이후 스마트 계약 기반의 자동화 기능이 발전하면서, 블록체인은 조직 간 계약 이행과 거버넌스 규칙을 디지털 환경에서 자동으로 실행․조정할 수 있는 메커니즘으로 확장되었다(Buterin, 2014; Szabo, 1997).
특히 공급망 및 조직 간 협업 환경에서 블록체인 기술은 안전하고 검증 가능한 정보 공유를 통해 투명성(transparency), 추적 가능성(traceability), 그리고 책임성(accountability)을 강화하는 것으로 나타났다. 또한 정보 비대칭을 완화하고 데이터 무결성을 향상시킴으로써 거래 비용과 조정 비용을 감소시키며, 조직 간 의사결정 동기화와 인센티브 정렬을 지원하는 것으로 보고되고 있다(Casino et al., 2019; Kshetri, 2017; Rejeb et al., 2021; Saberi et al., 2019).
거버넌스 관점에서 블록체인은 단순한 기술 인프라를 넘어, 분산 환경에서 의사결정 권한과 책임, 그리고 인센티브 구조를 설계하는 메커니즘으로 이해될 수 있다. 블록체인 기반 시스템의 거버넌스는 참여자 간 상호작용 방식과 거래 검증 절차, 인센티브 정렬 규칙이 프로토콜 수준에 내재되어 있다는 점에서 기존 중앙집중형 조정방식과 구별된다(Beck et al., 2018). 이러한 특성은 거래비용과 기회주의적 행동을 감소시키고 조직 간 조정 효율성을 높일 수 있다는 점에서 기존 경제학 기반 거버넌스 논의와도 연결된다(Treiblmaier, 2018).
이러한 논의를 종합하면, 분산형 데이터 거버넌스는 상호연결된 조직들이 데이터 관련 활동을 분산된 방식으로 검증하고, 규율하며, 조정할 수 있도록 하는 Web3 기반 디지털 거버넌스 구조로 이해될 수 있다. 이에 본 연구는 이러한 거버넌스 구조가 조직 간 데이터 공유와 협업 과정에서 구현되는 수준을 분산형 데이터 거버넌스로 개념화하였다.
구체적으로 분산형 데이터 거버넌스는 다음의 네 가지 구성요소로 이루어진다. 첫째, 데이터 소유권 및 접근 권한(data ownership and access rights)은 조직 간 데이터의 소유권, 사용 권한, 접근 권한이 명확하게 정의되고 일관되게 관리되는 정도를 의미한다(Beck et al., 2018; Kshetri, 2017). 이는 규칙 기반의 데이터 접근과 통제를 가능하게 한다. 둘째, 신뢰 및 검증 메커니즘(trust and verification mechanisms)은 공유 데이터와 거래 기록의 추적 가능성, 투명성, 검증 가능성을 의미하며, 이를 통해 조직 간 데이터 교환에서 데이터 무결성과 신뢰를 확보한다(Casino et al., 2019; Nakamoto, 2008). 셋째, 자동화된 조정 메커니즘(automated coordination mechanisms)은 스마트 계약 및 시스템 내장 규칙을 활용하여 거래 실행과 계약 이행을 자동화하고, 사전에 정의된 조건이 조직 간 환경에서 일관되게 적용되도록 하는 것을 의미한다(Buterin, 2014; Szabo, 1997). 넷째, 인센티브 정렬 메커니즘(incentive alignment mechanisms)은 참여 조직 간 데이터 공유와 협업을 촉진하기 위해 보상 체계, 공동 성과 메커니즘, 공정한 성과 분배 구조를 구축하는 정도를 의미한다(Rejeb et al., 2021; Treiblmaier, 2018).
분산형 데이터 거버넌스의 효과성은 개별 메커니즘의 존재 여부보다, 이들 메커니즘이 일관된 거버넌스 체계로 통합되어 운영되는 정도에 달려 있다. 즉, 이는 단순히 블록체인 기술의 도입 여부에 있는 것이 아니라, 제도적․조직적 환경과의 정합성을 바탕으로 거버넌스 메커니즘이 조직 간 상호작용 속에 얼마나 체계적으로 내재화되어 있는가에 의해 결정된다. 이러한 점에서 분산형 데이터 거버넌스는 기술적 요소와 조직적․제도적 요소가 결합된 사회기술적 거버넌스 구조로 이해될 수 있다.
Ⅲ. 가설개발
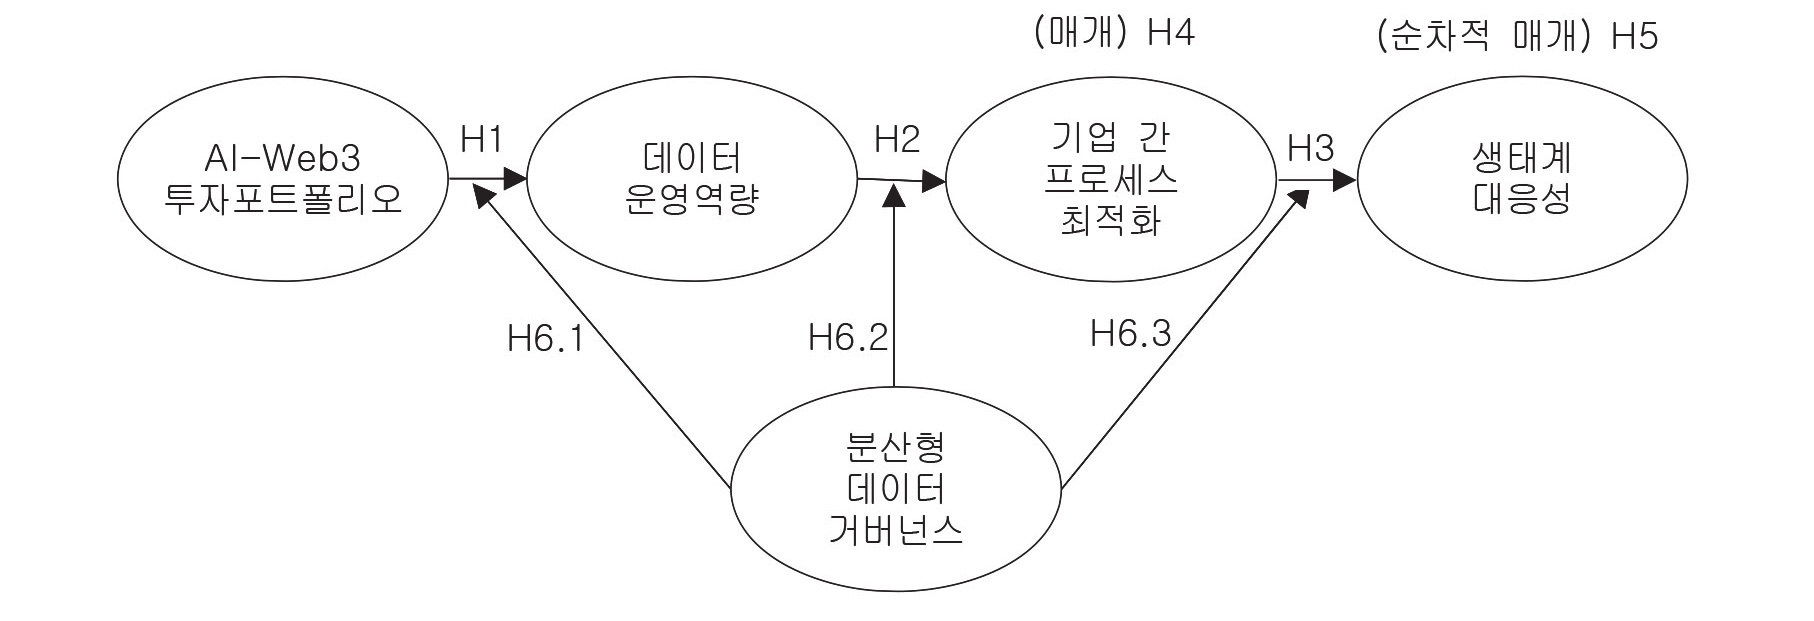
앞선 이론적 논의를 바탕으로, 본 연구는 AI 역량, 조직 간 프로세스, 그리고 생태계 대응성 간의 관계를 단순한 직접효과가 아니라 단계적이고 구조화된 전환 경로로 개념화한다. 구체적으로 본 연구는 AI-Web3 투자 포트폴리오(AI-Web3 Investment Portfolio, INV)의 가치가 직접적으로 성과로 이어지는 것이 아니라, 데이터 운영역량(Data Operational Capability, DATA)의 형성과 기업 간 프로세스 최적화(Inter-organizational Process Optimization, IPO)를 거쳐 점진적으로 실현된다고 본다. 즉, AI 기반 투자자원은 우선 데이터의 통합․관리․활용 역량을 강화하고, 이러한 데이터 역량은 다시 조직 간 실행 프로세스의 정렬과 협업적 운영을 가능하게 하며, 최종적으로 생태계 수준의 대응성(Ecosystem Responsiveness, ER)을 향상시키는 구조이다. 더 나아가, 데이터 공유와 조직 간 조정이 이루어지는 과정에서는 분산형 데이터 거버넌스(Decentralized Data Governance, DDG)와 같은 거버넌스 조건이 중요한 역할을 수행할 수 있다.
3.1 AI 기반 공급망 전환 (H1~H3)
선행연구에 따르면 디지털 전환의 성과는 단순한 기술 도입 자체에서 발생하는 것이 아니라, 기술․데이터․조직 자원이 얼마나 효과적으로 결합되고 운영되는가에 의해 결정된다(Barney, 1991; Sirmon et al., 2011). 특히 데이터 운영역량은 데이터의 수집․통합․관리․공유․활용을 지원하는 기술적 인프라와 이를 운영 및 활용할 수 있는 조직적 역량의 결합을 통해 형성된다(Gupta and George, 2016; Mikalef et al., 2018). 본 연구에서 AI-Web3 투자 포트폴리오(INV)는 이러한 데이터 운영역량의 형성을 지원하는 핵심 투자 자원의 집합으로서 AI 기술 인프라, 데이터 인프라, Web3 인프라, 그리고 인적․조직 자원으로 구성된다.
먼저, AI 기술 인프라는 클라우드 기반 컴퓨팅 환경, 데이터 기반 의사결정 시스템, AI 모델 운영 체계 등을 통해 대규모 데이터의 수집․처리․분석을 지원함으로써 데이터 활용 역량의 기반을 제공한다(Mikalef et al., 2020; Sculley et al., 2015). 데이터 인프라는 운영 데이터의 수집․저장․통합․관리 체계를 구축하여 데이터의 일관성과 품질을 향상시키고, 조직 전반의 데이터 접근성과 활용 가능성을 높인다(Khatri and Brown, 2010; McAfee et al., 2012). 또한 Web3 인프라는 블록체인 기반의 분산 저장과 스마트계약 자동화를 통해 기업 간 데이터 공유의 신뢰성과 투명성을 확보함으로써 조직 간 데이터 연계 및 활용을 지원한다(Beck et al., 2018; Tapscott and Tapscott, 2016). 마지막으로 인적․조직 자원은 AI 및 데이터 전문 인력, 교육․훈련, 역량 개발 체계를 통해 데이터를 운영 의사결정과 실행 과정에 효과적으로 적용할 수 있는 조직적 활용 역량을 강화한다(Ghafoori et al., 2024; Mikalef et al., 2019a).
이처럼 AI 기술 인프라, 데이터 인프라, Web3 인프라, 그리고 인적․조직 자원은 상호 보완적으로 결합되어 운영 데이터의 수집․통합․관리․공유․활용을 지원하며 데이터 기반 의사결정과 운영 실행 능력을 강화한다. 특히 AI 기술 인프라는 데이터 처리와 분석을 가능하게 하고, 데이터 인프라는 데이터 품질과 접근성을 확보하며, Web3 인프라는 신뢰 기반의 데이터 공유를 지원하고, 인적․조직 자원은 이러한 기술과 데이터를 실제 운영 활동에 적용하도록 한다. 따라서 INV는 데이터 운영역량(DATA)의 형성을 촉진할 것으로 예상된다.
H1. AI-Web3 투자 포트폴리오(INV)는 데이터 운영역량(DATA)에 정(+)의 영향을 미칠 것이다.
이와 같이 형성된 데이터 운영역량(DATA)은 다시 기업 간 프로세스 최적화(IPO)를 가능하게 한다. 데이터 통합 역량은 외부 파트너와의 실시간 데이터 연계와 시스템 간 정보 통합을 지원함으로써 조직 간 정보 흐름을 강화한다(Lee et al., 1997; Rai et al., 2006). 데이터 품질 및 관리 역량은 공유 데이터의 정확성․신뢰성․일관성을 확보함으로써 기업 간 협업 과정에서 발생하는 조정 불확실성을 감소시킨다(Khatri and Brown, 2010; Wang and Strong, 1996). 또한 데이터 활용역량은 분석 결과를 공동 계획 수립과 운영 실행 프로세스에 반영함으로써 조직 간 프로세스 연계와 협업 실행 수준을 향상시킨다(Mikalef et al., 2019a; Wamba et al., 2017). 나아가 데이터 기반 모니터링 체계는 운영 상황에 대한 실시간 추적성과 가시성을 제공하여 공급망 전반의 문제를 신속하게 식별하고 대응할 수 있도록 한다(Srinivasan and Swink, 2018; Wiengarten et al., 2013). 따라서 DATA는 정보 흐름, 프로세스 연계, 추적성 및 가시성으로 구성된 기업 간 프로세스 최적화(IPO)를 촉진할 것으로 예상된다.
H2. 데이터 운영역량(DATA)은 기업 간 프로세스 최적화(IPO)에 정(+)의 영향을 미칠 것이다.
기업 간 프로세스 최적화(IPO)는 궁극적으로 생태계 대응성(ER)을 향상시킨다. 우선 정보 흐름의 통합은 기업 간 의사결정 속도와 운영 조정 속도를 높여 변화 상황에 대한 신속한 대응을 가능하게 한다(Flynn et al., 2010). 프로세스 연계는 공급망 참여자 간 공동 운영과 협력적 문제 해결을 촉진하여 환경 변화에 대한 집단적 대응 능력을 강화한다(Sambamurthy et al., 2003). 또한 추적성과 가시성은 공급망 전반에 대한 실시간 모니터링과 문제 원인 분석을 가능하게 하여 운영 중단 상황에서도 빠른 복구와 재구성을 지원한다(Srinivasan and Swink, 2018). 결과적으로 IPO는 대응 속도, 협력적 문제 해결, 적응 및 재구성, 회복 탄력성과 같은 생태계 수준의 동태적 대응역량을 강화하는 실행 메커니즘으로 작동한다.
H3. 기업 간 프로세스 최적화(IPO)는 생태계 대응성(ER)에 정(+)의 영향을 미칠 것이다.
종합하면, AI-Web3 투자 포트폴리오(INV)는 데이터 운영역량(DATA)을 형성하고, 이러한 데이터 역량은 기업 간 프로세스 최적화(IPO)를 촉진하며, 궁극적으로 생태계 대응성(ER)으로 이어지는 순차적 전환 경로를 형성한다고 볼 수 있다.
3.2 매개 및 순차적 관계 (H4~H5)
본 연구는 기업 간 프로세스 최적화(IPO)가 AI-Web3 투자 포트폴리오(INV)와 생태계 대응성(ER)을 연결하는 핵심 매개 메커니즘으로 작동할 것으로 본다. AI 및 Web3 관련 기술, 데이터 인프라, 디지털 플랫폼에 대한 투자는 기업의 디지털 전환 기반을 강화하고 새로운 협업 가능성을 제공한다(Bharadwaj, 2000). 그러나 이러한 투자 자체가 곧바로 생태계 대응성으로 이어지는 것은 아니다. 자원관리관점에 따르면 기술 투자의 효과가 실질적인 운영 성과로 구현되기 위해서는 투자된 기술과 자원이 조직 간 운영 프로세스에 내재화되고 활용되어야 한다(Mikalef et al., 2019b; Sirmon et al., 2011).
특히 기업 간 프로세스 최적화는 AI-Web3 투자로 확보된 기술적 자원과 디지털 인프라를 실제 운영 및 협업 활동으로 전환하는 실행 메커니즘의 역할을 수행한다(Sirmon et al., 2011; Teece, 2007). AI 기반 예측 및 의사결정 기술은 공급망과 가치사슬 전반의 운영 효율성과 의사결정 품질을 향상시키고(Mikalef et al., 2020), Web3 기반 기술은 참여 기업 간 데이터 공유, 추적성 및 신뢰 확보를 지원한다(Beck et al., 2018; Saberi et al., 2019). 이러한 기술적 기반은 기업 간 프로세스가 효과적으로 연계되고 최적화될 때 비로소 운영 유연성, 협업 효율성 및 환경변화 대응역량으로 연결될 수 있다(Rai et al., 2006; Srinivasan and Swink, 2018).
자원기반관점에 따르면 경쟁우위는 자원의 보유 자체가 아니라 자원을 활용하는 조직역량을 통해 창출된다(Barney, 1991). 따라서 AI-Web3 투자 포트폴리오는 전략적 자원으로 기능하며, 기업 간 프로세스 최적화는 이러한 자원을 실제 가치로 전환하는 실행 역량으로 작동한다. 결과적으로 AI-Web3 투자의 효과는 기업 간 프로세스 최적화를 통해 생태계 대응성으로 이어질 것이다.
H4. 기업 간 프로세스 최적화(IPO)는 AI-Web3 투자 포트폴리오(INV)와 생태계 대응성(ER) 간의 관계를 매개할 것이다.
더 나아가 본 연구는 AI-Web3 투자 포트폴리오(INV)에서 생태계 대응성(ER)에 이르는 경로가 순차적 구조를 가진다고 본다. 즉, AI 투자 효과는 단순히 기술 도입만으로 실현되는 것이 아니라, 우선 데이터 운영역량(DATA)을 형성하고, 이후 이러한 데이터 역량이 조직 간 프로세스 최적화(IPO)로 전환될 때 비로소 생태계 수준의 적응성(ER)으로 이어진다.
구체적으로 AI 및 Web3 기반 투자자원은 데이터 수집․통합․분석 및 분산형 협업 역량 형성을 지원하며, 이러한 데이터 운영역량은 조직 간 정보 공유와 협업 실행 구조를 강화한다. 이후 최적화된 기업 간 프로세스는 공급망 참여자 간 공동 대응과 운영 재구성을 가능하게 함으로써 궁극적으로 생태계 대응성을 향상시킨다(Mikalef et al., 2019b; Sirmon et al., 2011).
H5. AI-Web3 투자 포트폴리오(INV)는 데이터 운영역량(DATA)과 기업 간 프로세스 최적화(IPO)를 순차적으로 매개하여 생태계 대응성(ER)에 영향을 미칠 것이다.
3.3 분산형 데이터 거버넌스의 역할 (H6.1~H6.3)
기업 간 협업 환경에서 데이터 기반 실행은 기업 내부 역량뿐 아니라 기업 간 데이터 공유와 협업을 조정하는 거버넌스 구조에도 영향을 받는다. 특히 AI와 Web3 기반 운영 환경에서는 다수의 참여자가 데이터를 공동으로 활용하기 때문에 신뢰와 조정 메커니즘의 중요성이 더욱 커진다. 분산형 데이터 거버넌스(DDG)는 데이터 접근 규칙, 검증 메커니즘, 그리고 분산형 신뢰 구조를 기반으로 참여자 간 데이터 공유와 협업을 지원하는 거버넌스 체계로 이해된다(Beck et al., 2018; Tapscott and Tapscott, 2016; Treiblmaier, 2018).
먼저, 분산형 데이터 거버넌스는 AI-Web3 투자 포트폴리오(INV)가 데이터 운영역량(DATA)으로 전환되는 과정에 영향을 미칠 수 있다. 데이터 접근 권한과 공유 기준, 데이터 품질관리 체계가 명확할수록 AI 및 Web3 기반 자원의 활용 가능성과 조직 간 데이터 연계 수준이 높아질 수 있다. 따라서 DDG 수준이 높을수록 INV와 DATA 간의 관계가 강화될 것으로 예상된다.
H6.1. 분산형 데이터 거버넌스(DDG)는 AI-Web3 투자 포트폴리오(INV)와 데이터 운영역량(DATA) 간의 관계를 정(+)의 방향으로 조절할 것이다.
둘째, 분산형 데이터 거버넌스는 데이터 운영역량(DATA)이 기업 간 프로세스 최적화(IPO)로 연결되는 과정에 영향을 미칠 수 있다. 데이터 기반 협업 환경에서는 데이터의 보유 자체보다 신뢰성 있는 공유와 활용이 중요하며, DDG는 데이터 접근 통제와 검증 메커니즘을 통해 기업 간 정보 비대칭성과 조정 불확실성을 감소시키며, 데이터 기반 공동 운영과 프로세스 연계를 보다 효과적으로 지원한다. 이에 따라 DDG 수준이 높을수록 DATA가 IPO로 연결되는 효과가 강화될 것으로 예상된다.
H6.2. 분산형 데이터 거버넌스(DDG)는 데이터 운영역량(DATA)과 기업 간 프로세스 최적화(IPO) 간의 관계를 정(+)의 방향으로 조절할 것이다.
마지막으로, 분산형 데이터 거버넌스는 기업 간 프로세스 최적화(IPO)가 생태계 대응성(ER)으로 이어지는 과정에 영향을 미칠 수 있다. 참여 조직 간 신뢰와 정보 투명성이 확보될수록 공동 의사결정과 협업적 대응이 용이해지며, 운영 중단이나 환경 변화 상황에서도 보다 효과적인 조정이 가능해질 수 있다. 따라서 DDG 수준이 높을수록 IPO와 ER 간의 관계가 강화될 것으로 예상된다.
H6.3. 분산형 데이터 거버넌스(DDG)는 기업 간 프로세스 최적화(IPO)와 생태계 대응성(ER) 간의 관계를 정(+)의 방향으로 조절할 것이다.
종합하면, 본 연구는 분산형 거버넌스 환경 하에서 AI 역량이 데이터 운영역량과 조직 간 프로세스 메커니즘을 통해 기업 간 프로세스 최적화 및 생태계 대응성으로 전환되는 구조적 경로를 제시한다. 이와 같은 변수와 가설을 토대로 본 연구의 연구모형은 그림 1과 같다.
Ⅳ. 연구방법
4.1 측정도구
본 연구는 AI-Web3 투자 포트폴리오(INV), 데이터 운영역량(DATA), 기업 간 프로세스 최적화(IPO), 생태계 대응성(ER), 분산형 데이터 거버넌스(DDG)의 다섯 가지 핵심 구성개념을 분석 대상으로 설정하였다. 모든 변수는 5점 리커트 척도를 활용한 다항목 측정 방식으로 구성하였다. 측정 문항은 기존 선행연구를 바탕으로 개발하였으며, AI 기반 공급망 운영과 조직 간 협업 및 생태계 환경의 맥락에 맞게 수정․보완하였다(표 1 참고).
<표 1> 측정도구와 설문문항
| 구성개념 | 변수 | N | 주요 측정 항목 | 참고문헌 |
|---|---|---|---|---|
| AI–Web3 투자 포트폴리오 (INV) | AI 기술 인프라 | 3 | 클라우드 컴퓨팅, 데이터 기반 의사결정 시스템, AI 모델운영ㆍ성능관리 | Bharadwaj, 2000; Mikalef et al., 2020; Sculley et al., 2015 |
| 데이터 인프라 | 3 | 데이터 수집, 데이터 통합 저장 환경, 데이터 품질관리 체계 | Gupta and George, 2016; Khatri and Brown, 2010 | |
| Web3 인프라 | 3 | 분산 데이터 저장ㆍ검증, 스마트 계약 자동화, Web3 기반 데이터 협업 | Babich and Hilary, 2020; Beck et al., 2018; Saberi et al., 2019 | |
| 인적ㆍ조직 자원 | 3 | AIㆍ데이터 전문인력, 교육ㆍ훈련, AIㆍ데이터 투자 로드맵 | Ghafoori et al., 2024; Kane et al., 2015; Mikalef et al., 2019a | |
| 데이터 운영역량 (DATA) | 데이터 통합 | 3 | 데이터 연계ㆍ자동화, 데이터 통합 활용, 데이터 표준화ㆍ일관성 | Ghahramani et al., 2020; Gupta and George, 2016 |
| 데이터 품질 및 관리 | 3 | 데이터 관리 책임ㆍ역할, 접근 권한 관리, 데이터 정확성ㆍ신뢰성 | Khatri and Brown, 2010; Peixoto et al., 2025; Wang and Strong, 1996 | |
| 데이터 활용 | 3 | 데이터 기반 의사결정, 프로세스 지속 개선, 데이터 운영 기준화 | Božič and Dimovski, 2019; Mikalef et al., 2019a; Wamba et al., 2017 | |
| 기업 간 프로세스 최적화 (IPO) | 정보 흐름 | 3 | 운영 데이터 공유, 시스템 간 자동 연계, 데이터 기반 공동계획 | Lee et al., 1997; Rai et al., 2006 |
| 프로세스 연계 | 3 | 운영 프로세스 연결, 공동 운영ㆍ의사 결정, 프로세스 지속 개선 | Davenport, 1993; Subramani, 2004; Swink et al., 2007 | |
| 추적성 및 가시성 | 3 | 실시간 운영 모니터링, End-to-end 가시성, 데이터 기반 문제 진단 | Saberi et al., 2019; Srinivasan and Swink, 2018 | |
| 생태계 대응성 (ER) | 대응 속도 | 2 | 운영 실행 조정 속도, 신속한 운영 의사결정 | Overby et al., 2006; Roberts and Grover, 2012 |
| 협력적 문제 해결 | 2 | 공동 원인 분석, 협력 기반 공동 대응 | Pavlou and El Sawy, 2011; Sambamurthy et al., 2003 | |
| 적응 및 재구성 | 2 | 단기 대응 운영 유연성, 구조ㆍ프로세스 재구성 | Eisenhardt and Martin, 2000; Teece, 2007 | |
| 회복 탄력성 | 2 | 협력 기반 운영 지속, 신속한 운영 복구ㆍ정상화 | Ambulkar et al., 2015; Wieland and Wallenburg, 2013 | |
| 분산형 데이터 거버넌스 (DDG) | 소유권 및 접근 | 2 | 데이터 소유권ㆍ사용 권한, 데이터 접근 통제ㆍ관리 | Beck et al., 2018; Kshetri, 2017 |
| 신뢰 및 검증 | 2 | 데이터 추적성ㆍ변경 이력, 데이터 정확성ㆍ신뢰성 검증 | Casino et al., 2019; Nakamoto, 2008 | |
| 자동화된 조정 | 2 | 규칙 기반 자동 실행, 계약 조건 자동화ㆍ일관성 | Buterin, 2014; Szabo, 1997 | |
| 인센티브 정렬 | 2 | 협업 인센티브 체계, 협업 성과의 공정한 배분 | Rejeb et al., 2021; Treiblmaier, 2018 |
AI-Web3 투자 포트폴리오(INV)는 기업이 AI 기반 운영과 조직 간 협업을 지원하기 위해 기술적․데이터․분산형․조직적 자원에 얼마나 체계적으로 투자하고 있는지를 의미한다. Beck et al.(2018), Bharadwaj(2000), Mikalef et al.(2019a) 등의 연구를 기반으로 INV는 AI 기술 인프라, 데이터 인프라, Web3 인프라, 인적 및 조직 자원의 네 가지 차원으로 구성된 총 12개 문항으로 측정하였다. 해당 차원은 클라우드 컴퓨팅 환경, 데이터 관리 인프라, 블록체인 기반 협업 메커니즘, 그리고 AI 및 데이터 활용을 지원하는 조직적 실행 기반 수준을 평가한다.
데이터 운영역량(DATA)은 기업이 운영 실행과 의사결정을 지원하기 위해 데이터를 체계적으로 통합․관리․활용하는 능력을 의미한다. Gupta and George(2016), Peixoto et al.(2025) 등의 연구를 기반으로 DATA는 데이터 통합, 데이터 품질 및 관리, 데이터 활용의 세 가지 차원으로 구성된 총 9개 문항으로 측정하였다. 해당 차원은 데이터 연계 체계, 신뢰성 있는 데이터 관리 및 통제 체계, 그리고 분석 결과를 운영 프로세스와 지속적 개선 활동에 내재화하는 정도를 측정한다.
기업 간 프로세스 최적화(IPO)는 기업이 외부 파트너와 디지털 기반으로 연결된 프로세스를 통해 운영 조정과 실행을 얼마나 최적화하고 있는지를 의미한다. 공급망 통합 및 조직 간 시스템 연구(Lee et al., 1997; Srinivasan and Swink, 2018; Swink et al., 2007) 등을 기반으로 IPO는 정보 흐름, 프로세스 연계, 추적 가능성과 가시성의 세 가지 차원으로 구성된 총 9개 문항으로 측정하였다. 해당 차원은 운영 데이터 공유, 시스템 기반 프로세스 연계, 공동 운영 및 기업 간 실시간 운영 가시성을 평가한다.
생태계 대응성(ER)은 기업이 운영상의 불확실성, 환경 변화, 그리고 조직 간 협업 요구에 효과적으로 대응할 수 있는 역량을 의미한다. Ambulkar et al.(2015), Pavlou and El Sawy(2011), Roberts and Grover(2012), Teece(2007) 등의 연구를 기반으로 ER은 대응 속도, 협력적 문제 해결, 적응 및 재구성, 회복탄력성의 네 가지 차원으로 구성된 총 8개 문항으로 측정하였다. 해당 차원은 운영 조정의 신속성, 외부 파트너와의 공동 문제 해결 능력, 운영 구조의 유연한 재구성 능력, 그리고 불확실한 상황에서 운영을 유지․복구하는 능력을 반영한다
분산형 데이터 거버넌스(DDG)는 기업 간 데이터와 거래를 신뢰성 있고 투명하며 자동화된 방식으로 조정할 수 있도록 지원하는 거버넌스 메커니즘을 의미한다. 블록체인 및 분산형 거버넌스 관련 연구(Beck et al., 2018; Nakamoto, 2008; Treiblmaier, 2018) 등을 기반으로 DDG는 소유권 및 접근 권한, 신뢰 및 검증, 자동화된 조정, 인센티브 정렬의 네 가지 차원으로 구성된 총 8개 문항으로 측정하였다. 해당 차원은 공유 데이터 권한의 명확성, 데이터 거래 기록의 추적 가능성과 신뢰성, 시스템 기반 자동화 규칙 적용, 그리고 데이터 공유 및 협업 촉진을 위한 보상․성과 분배 체계를 평가한다.
측정 문항의 내용 타당성과 맥락 적합성을 확보하기 위해, 설문 배포 이전에 AI․디지털 전환, 공급망 운영 분야의 학계 전문가 및 산업 실무자를 대상으로 문항 검토를 실시하였다.
4.2 자료수집 및 표본의 특성
본 연구의 데이터는 2026년 3월부터 약 4주간 전문 온라인 리서치 기관을 통해 수집되었다. 연구 대상은 전기․전자․반도체․자동차 중심의 제조업과 물류․운송 등 유통 관련 산업의 기업으로 설정하였다. 이는 해당 산업들이 공급망 중심의 운영 구조를 기반으로 기업 간 협업과 정보 연계 수준이 높으며, 실시간 의사결정과 운영 최적화를 위한 AI 및 데이터 기반 운영 도입이 빠르게 확산되고 있기 때문이다.
특히, 한국은 높은 제조 자동화 수준과 디지털 물류 인프라를 동시에 보유하고 있다는 점에서 본 연구의 실증 맥락으로 적합하다. International Federation of Robotics(2024)에 따르면 한국의 산업용 로봇 밀도는 근로자 1만 명당 약 1,012대로, 독일(429), 일본(419), 미국(295)을 크게 상회한다. 또한 한국의 유통․물류 산업은 전자상거래 기반의 실시간 배송 체계, 통합 물류 플랫폼, 그리고 데이터 기반 재고․운송 관리 시스템을 중심으로 빠른 디지털 전환이 이루어지고 있다(김도훈, 2023; 이성주 외, 2022; 장지영 외, 2022). 이러한 제조․유통 환경의 특성은 공급망 참여자 간 데이터 협업, 운영 조정, 그리고 생태계 대응성과 같은 AI 기반 공급망 전환 메커니즘을 분석하기에 적합한 환경을 제공한다.
응답자는 생산운영, SCM/물류, 디지털 전환 관련 직무 종사자를 중심으로 선정하였으며, 최소 5년 이상의 실무 경력을 보유한 경우에 한해 조사 대상에 포함하였다. 또한 응답의 품질과 맥락적 적합성을 확보하기 위해, 응답자 수준에서는 AI․데이터 활용 및 공급망 협업에 대한 이해와 경험을 기준으로 사전 스크리닝을 실시하였고, 기업 수준에서는 외부 파트너와 데이터 공유를 수행하지 않는 기업을 조사 대상에서 제외하였다. 이는 본 연구가 개방형 생태계의 전환 메커니즘을 분석하는 데 목적을 두고 있으며, 생태계 대응성(ER)이 외부 파트너와의 데이터 연계 및 협업을 전제로 하는 개념이기 때문이다.
전체 조사 참여자 대비 최종 완료 응답자의 비율(IR: Incidence Rate)은 4.6%로 나타났으며, 이는 엄격한 스크리닝 기준을 충족한 응답자만이 최종 분석에 포함되었음을 의미하며, 최종 표본의 신뢰성과 맥락적 적합성을 뒷받침하는 결과로 해석할 수 있다.
표본의 다양성을 확보하고 잠재적 표집 편향을 최소화하기 위해 자료수집은 2단계에 걸쳐 수행되었다. 1차 조사에서는 AI 및 디지털 기술 활용 경험이 있는 기업을 중심으로 응답을 수집하였다. 그러나 예비 분석 결과, 디지털화 수준이 높은 기업의 비중이 상대적으로 높게 나타나 일부 변수에서 분산이 제한되는 ceiling effect 가능성이 확인되었다. 이에 2차 조사에서는 응답자 스크리닝 기준과 표집 조건을 보완하여 디지털 활용수준이 다양한 기업들이 포함될 수 있도록 표본을 추가 확보하였다. 이를 통해 기업 규모, 산업 특성, 디지털 성숙도 및 공급망 운영 환경 측면에서 보다 폭넓은 표본 구성을 확보하고자 하였다. 최종적으로 응답 품질 검토를 거쳐 유효 표본 136부를 분석에 활용하였다.
최종 표본에서 응답자의 약 76%가 10년 이상의 직장경력을 보유하고 있었으며, 과장급 이상 관리자 비중도 약 86%에 달하였다. 또한 응답자 대부분은 재직기업의 데이터․AI 기반 공급망 운영에 대해 기본 수준 이상의 이해를 갖추고 있었고, 분산형 데이터 기술 및 기업 간 공급망 협업에 대해서도 전반적으로 높은 이해도와 실무 경험을 보였다. 이는 본 연구의 응답자들이 공급망 운영과 디지털 전환 관련 의사결정 및 실행에 직접 참여하는 숙련된 실무자 집단임을 시사한다(다음 페이지 표 2 참고).
<표 2> 응답자 특성
| 직무 | 직장경력 | 직급 | |||
|---|---|---|---|---|---|
| 생산/운영 | 36 | 3년 미만 | 0 | 사원 | 0 |
| SCM/구매/조달 | 24 | 3년 이상 - 5년 미만 | 0 | 대리 | 19 |
| 물류/유통/재고관리 | 21 | 5년 이상 - 7년 미만 | 10 | 과장 | 33 |
| 품질/공정개선 | 28 | 7년 이상 - 10년 미만 | 23 | 차장 | 33 |
| IT/데이터/AI/디지털전환 | 7 | 10년 이상 - 15년 미만 | 37 | 부장 | 43 |
| 전략기획/사업기획 | 20 | 15년 이상 | 66 | 임원 | 7 |
| 영업/마케팅 | 0 | 대표/사업책임자 | 1 | ||
| 이해 수준 | 실무 경험 | ||||
| 재직기업 AI․데이터․공급망 운영 | 블록체인․분산형 데이터 기술 | 기업 간 공급망 협업 | |||
| 전혀 알지 못함 | 0 | 전혀 모름 | 0 | 관련 경험 없음 | 0 |
| 일부만 알고 있음 | 0 | 매우 낮다 | 0 | 보조적 참여 등 단순 지원 | 20 |
| 기본 수준에서 알고 있음 | 63 | 낮다 | 30 | 일상 업무 수행 등 운영 참여 | 51 |
| 전반적으로 잘 알고 있음 | 57 | 보통이다 | 71 | 프로세스 관리/조정 | 49 |
| 매우 잘 알고 있음 | 16 | 높다 | 26 | 전략 등 의사결정 | 16 |
| 매우 높다 | 9 | ||||
응답 기업은 기업 규모 측면에서 비교적 균형 있게 분포하였다. 업종별로는 제조업이 전체 표본의 74.3%를 차지하여 가장 높은 비중을 보였으며, 물류․운송 및 유통 관련 산업도 25.7%를 차지하였다. 또한 전체 기업의 76.5%는 20개 이상의 외부 파트너와 협력하고 있어, 본 표본은 복잡한 공급망 네트워크 환경에서 운영되는 기업들을 폭넓게 포함하고 있음을 보여준다. 재직 기업의 AI․디지털 기술의 활용 수준에서는 일부 부서 또는 업무 단위에서 활용 중인 기업이 64.7%로 가장 높은 비중을 차지하였으며, 주요 업무 및 의사결정 수준까지 활용하는 기업도 21.3%로 나타났다. 그리고 생산․물류 등 주요 운영 프로세스의 디지털화 수준 역시 데이터 기반 관리(36.8%)와 부서 간 통합 운영(40.4%)이 높은 비중을 차지하였다. 또한 협력사, 물류, 유통 등 등 외부 파트너와의 시스템 연계는 제한적 시스템 연계(35.3%)와 ERP/SCM 기반 연계(19.9%), 실시간 플랫폼 기반 통합(21.3%)으로 나타나 상당수 기업이 디지털 협업 체계를 구축하고 있는 것으로 확인되었다. 공급망 운영 범위 역시 일부 또는 다수의 협력사를 포함하는 기업이 과반을 차지하였으며, 국내․글로벌 공급망 단위로 운영하는 기업도 상당 비중을 보여 다양한 공급망 환경을 포괄하는 표본으로 구성되었다(표 3 참고).
<표 3> 응답자 재직기업의 특성
| 규모 | 업종 | 주요 외부 파트너 수 | |||||
|---|---|---|---|---|---|---|---|
| 대기업 | 37 | 전자/전기/반도체5) | 61 | 5개 미만 | 6 | ||
| 중견기업 | 51 | 자동차/자동차부품6) | 40 | 5-20개 | 26 | ||
| 중소기업 | 48 | 기타 제조업 | 0 | 20-50개 | 48 | ||
| 물류/운송업7) | 10 | 50-100개 | 27 | ||||
| 유통/도소매/e커머스8) | 25 | 100개 이상 | 29 | ||||
| AI․디지털 운용 수준 | 공급망 운영 특성 | ||||||
| AI․디지털 기술 활용 | 운영 프로세스의 디지털화 | 외부 파트너와 시스템 연계 | 공급망 운영 범위 | ||||
| 전혀 활용하지 않음 | 1 | 도입하지 않음 | 1 | 전혀 없음 | 6 | 단일 공장 중심 | 4 |
| 파일럿, 실험 수준 | 7 | 일부 디지털화 | 15 | 수동적 데이터 공유 | 26 | 일부 협력사 포함 | 35 |
| 일부 부서/업무 활용 | 88 | 데이터 기반 관리 | 50 | 제한적 시스템 연계 | 48 | 다수 협력사 포함 | 43 |
| 주요 업무에 활용 | 29 | 통합 운영 (부서간) | 55 | ERP/SCM 기반 연계 | 27 | 국내 공급망 운영 | 22 |
| 전사적으로 통합 활용 | 11 | 지능형 운영 (최적화) | 15 | 실시간/플랫폼 통합 | 29 | 글로벌 공급망 운영 | 32 |
4.3 분석 방법
가설 검증을 위해 SPSS 23, AMOS 23, PROCESS Macro 4.0을 활용하였다. 기술통계, 탐색적 요인분석(EFA), 신뢰도 분석은 SPSS로 수행하였고, 확인적 요인분석(CFA)과 모형 적합도 평가는 AMOS로 분석하였다. 매개효과는 PROCESS Macro를 활용한 회귀 기반 경로분석으로 검증하였으며, 간접효과의 유의성은 부트스트래핑(5,000회)을 통해 확인하였다. 이러한 회귀 기반 분석은 공분산 기반 구조방정식모형에 비해 상대적으로 적은 표본에서도 안정적인 모수 추정이 가능한 것으로 알려져 있다(Hayes, 2022). 또한 본 연구는 확인적 요인분석을 중심으로 가설 모형을 검증하고, 측정구조의 타당성 확보를 위해 탐색적 요인분석을 병행하였다.
Ⅴ. 실증분석 및 가설검증
5.1 기술통계
연구모형 분석에 앞서 정규분포 가정을 검증하기 위해 각 변수의 평균, 표준편차, 왜도 및 첨도를 분석하였다(표 4 참고). 리커드 5점 척도로 측정된 변수들의 평균은 3.534~3.706 범위로 나타나 전반적으로 중간값을 상회하였으며, 표준편차는 0.761~0.870 범위로 비교적 안정적인 분산을 보였다. 또한 왜도는 -0.476~-0.190, 첨도는 -0.066~0.272 범위로 모두 ±1 이내에 분포하여 자료의 정규성 가정을 충족하는 것으로 확인되었다. 따라서 본 연구의 주요 변수들은 전반적으로 정규성이 확보된 것으로 판단된다(Hong et al., 2003).
<표 4> 기술통계
| 구성 개념 | 최소값 | 최대값 | 평균 | 표준편차 | 왜도 | 첨도 |
|---|---|---|---|---|---|---|
| AI-Web3 투자 포트폴리오 (INV) | 1.25 | 5.00 | 3.534 | 0.870 | -0.400 | 0.058 |
| 데이터 운영역량 (DATA) | 1.11 | 5.00 | 3.706 | 0.827 | -0.476 | 0.272 |
| 기업 간 프로세스 최적화 (IPO) | 1.22 | 5.00 | 3.603 | 0.833 | -0.329 | 0.008 |
| 생태계 대응성 (ER) | 1.50 | 5.00 | 3.680 | 0.761 | -0.262 | 0.018 |
| 분산형 데이터 거버넌스 (DDG) | 1.38 | 5.00 | 3.602 | 0.802 | -0.190 | -0.066 |
5.2 신뢰도 및 타당도 검증
측정항목의 요인구조를 확인하기 위해 SPSS 23을 활용한 탐색적 요인분석(EFA)을 수행하였다(다음 페이지 표 5 참고). 요인 추출은 주성분 분석을 적용하였으며, 요인의 해석 가능성을 높이기 위해 베리맥스 직교회전 방식을 사용하였다.
<표 5> 탐색적 요인분석(EFA)과 신뢰도, 타당도 분석
| 구성개념 | 문항 | 공통성 | 요인부하량 | CA | CR | AVE | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 키워드 | 1 | 2 | 3 | 4 | 5 | ||||||
| AI-Web3 투자 포트폴리오 (INV) | INV_INF1 | 클라우드환경 | .762 | .764 | .097 | .218 | .012 | .348 | .883 | .886 | .608 |
| INV_INF3 | AI모델운영 | .766 | .780 | .123 | .106 | .206 | .297 | ||||
| INV_HOR1 | AI전문인력 | .717 | .683 | .019 | .457 | .127 | .157 | ||||
| INV_HOR2 | 교육․훈련 | .694 | .679 | .163 | .179 | .409 | .079 | ||||
| INV_HOR3 | AI투자로드맵 | .776 | .700 | .188 | .048 | .473 | .159 | ||||
| 데이터 운영역량 (DATA) | DATA_INT1 | 데이터자동연계 | .649 | .269 | .601 | .448 | .112 | .045 | .805 | .804 | .510 |
| DATA_INT2 | 데이터통합활용 | .726 | .005 | .812 | .020 | .239 | .091 | ||||
| DATA_INT3 | 일관된데이터 | .690 | .269 | .656 | .397 | .124 | .117 | ||||
| DATA_QM3 | 데이터신뢰성 | .660 | .043 | .575 | .248 | .396 | .330 | ||||
| 기업 간 프로세스 최적화 (IPO) | IPO_INF1 | 운영데이터공유 | .577 | .183 | .390 | .578 | .142 | .194 | .805 | .806 | .511 |
| IPO_PI1 | 프로세스연계 | .630 | .194 | .273 | .648 | .116 | .291 | ||||
| IPO_TRV1 | 실시간모니터링 | .662 | .323 | .235 | .615 | .230 | .266 | ||||
| IPO_TRV2 | E2E 가시성 | .690 | .091 | .033 | .696 | .384 | .220 | ||||
| 생태계 대응성 (ER) | ER_RSP2 | 신속한의사결정 | .656 | .200 | .319 | .146 | .700 | -.057 | .821 | .822 | .483 |
| ER_CPS1 | 공동원인분석 | .626 | .193 | .179 | .348 | .550 | .364 | ||||
| ER_CPS2 | 협력기반공동대응 | .660 | .291 | .154 | .408 | .614 | .090 | ||||
| ER_ADR2 | 프로세스재구성 | .548 | .277 | .285 | .106 | .556 | .264 | ||||
| ER_RES2 | 신속한정상화 | .615 | .122 | .043 | .128 | .673 | .358 | ||||
| 분산형 데이터 거버넌스 (DDG) | DDG_ATC1 | 규칙기반자동실행 | .750 | .146 | .356 | .375 | .061 | .677 | .843 | .844 | .574 |
| DDG_ATC2 | 계약조건자동화 | .650 | .143 | .258 | .213 | .368 | .618 | ||||
| DDG_INA1 | 협업인센티브 | .763 | .306 | .004 | .143 | .160 | .790 | ||||
| DDG_INA2 | 공정한성과배분 | .681 | .258 | .050 | .183 | .148 | .746 | ||||
| 분산비율(%) | 15.4 | 11.8 | 13.3 | 13.8 | 13.6 | ||||||
| 누적분산비율(%) | 15.4 | 27.2 | 40.5 | 54.3 | 67.9 | ||||||
주) 1) KMO 표준 적합도 지수 = 0.917, Bartlett 구형성 검정 유의확률 p < .001
2) CA(Cronbach’s α) > .70, CR(개념신뢰도) > .70, AVE(평균분산추출) > .50
탐색적 요인분석 결과, KMO(Kaiser-Meyer-Olkin) 표본 적합도는 0.917로 나타나 매우 우수한 수준을 보였으며, Bartlett의 구형성 검정 역시 p<.001 수준에서 유의한 것으로 확인되어 요인분석 적용에 적합한 자료로 판단되었다. 또한 각 측정항목의 공통성은 0.548~0.776 범위로 나타나 권장 기준인 0.5를 모두 상회하였다. 요인부하량은 0.550~0.812 수준으로 확인되어 대부분의 문항이 해당 요인을 적절하게 설명하는 것으로 나타났다. 아울러 추출된 요인들의 누적 설명분산은 67.9%로 나타나 사회과학 연구에서 일반적으로 요구되는 기준을 충족하는 것으로 확인되었다. 따라서 본 연구의 측정항목들은 전반적으로 양호한 요인 구조를 보여 측정항목의 구조적 타당성을 뒷받침하는 것으로 판단된다(우종필, 2012).
또한 신뢰도 및 수렴 타당성 검증 결과, Cronbach's α는 0.805~0.883, 개념신뢰도(CR)는 0.804~0.886으로 모두 권장 기준인 0.7을 상회하였다. 평균분산]추출(AVE)은 0.483~0.608 범위로 일부 구성개념에서 기준치인 0.5에 소폭 미달하였으나, 해당 구성개념들의 CR 값이 모두 0.7 이상으로 나타나 Fornell and Larcker(1981)의 기준에 따라 수렴타당성은 수용 가능한 수준으로 판단하였다. 이에 따라 본 연구의 측정모형은 충분한 신뢰도와 수렴타당성을 확보한 것으로 평가된다.
측정모형의 구성타당성과 판별타당성을 제고하기 위해 교차적재(cross-loading) 또는 요인 적재가 불안정한 문항을 단계적으로 제거하였다. 문항 정제 결과, 분산형 데이터 거버넌스(DDG)의 소유권․접근 권한(DDG_OWN1)과 신뢰․검증(DDG_TRV1, DDG_TRV2) 문항은 기업 간 프로세스 최적화(IPO) 와 교차적재가 나타났다. 이는 데이터 소유권의 명확성, 데이터 이력 추적 및 신뢰성 검증과 같은 활동이 응답자들에게 거버넌스 체계 자체보다 기업 간 정보 공유와 협업 프로세스의 효율성을 나타내는 특성으로 인식되었기 때문으로 해석된다. 또한 AI-Web3 투자 포트폴리오(INV)의 데이터 인프라 투자(INV_DATA2, INV_DATA3) 문항은 데이터 운영역량(DATA)과 교차적재가 나타났다. 이는 데이터 통합 환경 구축 및 품질관리 체계가 단순한 투자 활동보다 실제 데이터 운영역량의 수준을 반영하는 것으로 인식되었기 때문으로 판단된다. 한편 Web3 인프라 투자(INV_WEB1, INV_WEB2, INV_WEB3) 문항은 특정 요인에 안정적으로 적재되지 않았다. 이는 응답자들이 Web3 인프라를 독립적인 투자 영역이라기보다 데이터 거버넌스와 기업 간 협업을 지원하는 기반 메커니즘으로 인식하였기 때문으로 해석된다. 이에 따라 본 연구의 최종 실증분석에서는 AI-Web3 투자 포트폴리오가 AI 기술 인프라, 데이터 인프라 및 인적․조직 자원을 중심으로 검증되었다. 이는 Web3 기술이 아직 국내 기업에서 독립적인 투자영역으로 충분히 정착되지 않았음을 시사하며, 본 연구에서는 이를 AI-Web3 투자 포트폴리오 개념 자체의 부정보다는 Web3 구성요소의 실증적 구현이 아직 제한적인 결과로 해석하였다.
5.3 측정모형의 적합도 및 판별타당성 평가
측정모형의 적합도를 검증하기 위해 AMOS 23을 활용한 확인적 요인분석(CFA)을 실시하였다. 모형 적합도는 절대적합지수와 증분적합지수를 중심으로 평가하였으며, 일반적으로 사용되는 권장 기준과 비교하여 적합성을 판단하였다(송지준, 2015; 한상숙 & 이상철, 2018).
분석 결과(표 6 참고), χ²=323.673, χ²/df=1.626, SRMR=.059, RMSEA=.068로 나타나 절대적합지수 기준을 전반적으로 충족하는 것으로 확인되었다. 또한 IFI=.922, TLI=.908, CFI=.920으로 모두 권장 기준인 .90 이상을 상회하였다. GFI는 .823으로 기준치(.90)에는 다소 미치지 못하였으나, 다른 적합도 지표들이 양호한 수준을 보여 측정모형은 전반적으로 수용 가능한 적합도를 갖는 것으로 판단하였다.
<표 6> 측정모형의 적합도
| 절대적합지수 | 증분적합지수 | ||||||||
|---|---|---|---|---|---|---|---|---|---|
| χ² | χ²/df | p | SRMR | GFI | RMSEA | IFI | TLI | CFI | |
| 323.673 | 1.626 | 0.000 | 0.059 | 0.823 | 0.068 | 0.922 | 0.908 | 0.920 | |
| 기준 | <3 | <.05 | <.08 | >.90 | <.08 | >.90 | >.90 | >.90 | |
다음으로 구성개념 간 판별타당성을 평가하기 위해 HTMT(Heterotrait-Monotrait Ratio)를 적용하였다. HTMT는 구성개념 간 상관이 높은 경우에도 판별타당성을 보다 엄격하게 평가할 수 있는 방법으로 널리 활용되고 있다(Hair et al., 2019; Henseler et al., 2015). 분석 결과(표 7 참고), HTMT 값은 최소 .636에서 최대 .841 범위로 나타났으며, 모든 값이 보수적 기준인 .85를 하회하였다. 특히 가장 높은 값은 DATA와 IPO 간의 .841로 나타났으나 기준치를 초과하지 않았다. 따라서 본 연구의 구성개념들은 상호 관련성을 가지면서도 개념적으로 충분히 구별되는 것으로 판단되며, 측정모형의 판별타당성이 확보된 것으로 확인되었다.
<표 7> 판별 타당성 (HTMT)
| 구성개념 | INV | DATA | IPO | ER | DDG |
|---|---|---|---|---|---|
| AI-Web3 투자 포트폴리오 (INV) | - | 0.640 | 0.733 | 0.822 | 0.699 |
| 데이터 운영역량 (DATA) | - | 0.841 | 0.781 | 0.636 | |
| 기업 간 프로세스 최적화 (IPO) | - | 0.829 | 0.802 | ||
| 생태계 대응성 (ER) | - | 0.729 | |||
| 분산형 데이터 거버넌스 (DDG) | - |
종합하면, 본 연구는 탐색적 요인분석(EFA)과 확인적 요인분석(CFA)을 통해 측정모형을 단계적으로 검증하였으며, 신뢰도, 수렴타당성 및 판별타당성(HTMT) 또한 전반적으로 수용 가능한 수준을 확인하였다. 따라서 본 연구의 측정모형은 제한된 표본 규모에서도 후속 구조모형 분석을 수행하기에 적절한 신뢰성과 타당성을 확보한 것으로 판단하였다.
5.4 가설검증
본 연구는 AI-Web3 투자 포트폴리오(INV)와 생태계 대응성(ER) 간 관계에서 데이터 운영역량(DATA)과 기업 간 프로세스 최적화(IPO)의 순차매개효과를 검증하기 위해 Hayes(2022)의 PROCESS Macro Model 6을 적용하였다. 분석에는 총 136개의 유효표본이 활용되었으며, 간접효과 검증을 위해 5,000회 부트스트래핑(Bootstrapping)을 실시하였다.
또한 분산형 데이터 거버넌스(DDG)의 조절효과는 PROCESS Macro Model 1을 통해 검증하였다. 구체적으로 DDG가 AI-Web3 투자 포트폴리오와 데이터 운영역량 간의 관계(INV→DATA), 데이터 운영역량과 기업 간 프로세스 최적화 간의 관계(DATA→IPO), 그리고 기업 간 프로세스 최적화와 생태계 대응성 간의 관계(IPO→ER)를 각각 조절하는지를 검증하기 위하여 세 개의 독립적인 조절회귀모형을 추정하였다. 조절효과의 유의성은 상호작용항의 회귀계수와 유의확률을 기준으로 판단하며, 상호작용항이 통계적으로 유의한 경우 DDG 수준에 따른 조건부 효과를 추가적으로 분석한다. 이를 통해 분산형 데이터 거버넌스가 AI-Web3 투자 포트폴리오의 효과가 데이터 운영역량, 기업 간 프로세스 최적화 및 생태계 대응성으로 전이되는 과정에서 어떠한 경로를 강화 또는 약화시키는지를 규명하고자 하였다.
5.4.1 직접효과 및 순차매개효과 검증 결과
먼저 표 8의 경로별 회귀분석 결과를 살펴보면, AI-Web3 투자 포트폴리오(INV)는 데이터 운영역량(DATA)에 유의한 정(+)의 영향을 미치는 것으로 나타나 H1이 지지되었다(B=0.423, p<.001). 또한 데이터 운영역량은 기업 간 프로세스 최적화(IPO)에 유의한 정(+)의 영향을 미쳐 H2가 지지되었으며(B=0.504, p<.001), 기업 간 프로세스 최적화는 생태계 대응성(ER)에 유의한 정(+)의 영향을 미치는 것으로 나타나 H3이 지지되었다(B=0.245, p=.001). 아울러 INV는 IPO와 ER에 유의한 정(+)의 영향을 미치는 것으로 확인되었다(B=0.310, p<.001; B=0.268, p<.001).
<표 8> 경로별 회귀분석 결과
| 종속변수 | 경로 | Effect (B) | S.E. | t-value | p (유의확률) | 결과 |
|---|---|---|---|---|---|---|
| DATA | INV → DATA (H1) | 0.423 | 0.063 | 6.689 | < .001 | 지지 |
| IPO | DATA → IPO (H2) | 0.504 | 0.067 | 7.543 | < .001 | 지지 |
| INV → IPO | 0.310 | 0.057 | 5.489 | < .001 | 유의 | |
| ER | IPO → ER (H3) | 0.245 | 0.075 | 3.272 | 0.001 | 지지 |
| DATA → ER | 0.247 | 0.069 | 3.582 | < .001 | 유의 | |
| INV → ER | 0.268 | 0.054 | 4.963 | < .001 | 유의 |
주) 종속변수 DATA 모형의 R²=.250,F=44.747; IPO 모형 R²=.563, F=85.679; ER 모형 R²=.593, F=64.165
다음으로 표 9의 총효과․직접효과․간접효과 분석 결과를 살펴보면, INV가 ER에 미치는 총효과는 0.500으로 나타났으며, DATA과 IPO를 통제한 이후에도 직접효과는 유의한 것으로 확인되었다(B=0.268, p<.001). 이는 투자 효과가 매개변수에 의해 전적으로 설명되지 않음을 의미하며, 부분매개 구조가 존재함을 시사한다. 또한 총간접효과는 유의한 것으로 나타났으며(B=0.232, 95% CI [0.124, 0.368]), 이는 INV가 ER에 미치는 총효과의 약 46.5%가 DATA와 IPO를 통한 간접경로에 의해 설명됨을 의미한다.
<표 9> 총효과 및 간접․직접효과 분석 결과
| 구분 | Effect (B) | Boot SE | 95% Bootstrap CI | 결과 | |
|---|---|---|---|---|---|
| LLCI | ULCI | ||||
| 총효과 | 0.500 | - | - | - | 유의 |
| 총간접효과 | 0.232 | 0.062 | 0.124 | 0.368 | 유의 |
| 직접효과 | 0.268 | 0.054 | 0.161 | 0.375 | 유의 |
마지막으로 다음 페이지 표 10의 간접효과 및 순차매개효과 검증 결과를 살펴보면, IPO의 단일 매개효과(INV→IPO→ER)가 유의한 것으로 나타나 H4가 지지되었다(B=0.076, 95% CI [0.014, 0.157]). 또한 INV가 DATA와 IPO를 순차적으로 거쳐 ER에 영향을 미치는 순차매개효과(INV→DATA→IPO→ER) 역시 유의한 것으로 확인되어 H5가 지지되었다(B=0.052, 95% CI [0.009, 0.111]). 따라서 DATA와 IPO는 INV와 ER 간의 관계를 순차적으로 매개하는 핵심 메커니즘으로 작용하는 것으로 확인되었다.
<표 10> 간접효과 및 순차매개효과 검증 결과
| 경로 | Effect (B) | Boot SE | 95% Bootstrap CI | 결과 | |
|---|---|---|---|---|---|
| LLCI | ULCI | ||||
| INV → DATA → ER | 0.104 | 0.044 | 0.032 | 0.206 | 유의 |
| INV → IPO → ER (H4) | 0.076 | 0.037 | 0.014 | 0.157 | 지지 |
| INV → DATA → IPO → ER (H5) | 0.052 | 0.026 | 0.009 | 0.111 | 지지 |
5.4.2 조절효과 검증 결과
분산형 데이터 거버넌스(DDG)의 조절효과를 검증하기 위해 PROCESS Macro Model 1을 활용하였다. 구체적으로 DDG가 AI-Web3 투자 포트폴리오와 데이터 운영역량 간의 관계(INV→DATA), 데이터 운영역량과 기업 간 프로세스 최적화 간의 관계(DATA→IPO), 그리고 기업 간 프로세스 최적화와 생태계 대응성 간의 관계(IPO→ER)를 각각 조절하는지를 검증하기 위하여 세 개의 독립적인 조절회귀모형을 추정하였다.
분석 결과는 표 11에 제시하였다. 먼저 INV와 DATA 간의 관계에서 상호작용항(INV×DDG)의 효과는 유의하지 않은 것으로 나타났다(B=-0.077, p=.277). 또한 DATA와 IPO 간의 관계에서도 상호작용항(DATA×DDG)이 유의하지 않은 것으로 확인되었다(B=0.024, p=.698). 마지막으로 IPO와 ER 간의 관계에서도 상호작용항(IPO×DDG)의 효과는 유의하지 않은 것으로 나타났다(B=-0.024, p=.699).
<표 11> 분산형 데이터 거버넌스(DDG)의 경로별 조절효과 검증 결과
| 경로 | DDG (B) | Interaction (B) | p (유의확률) | 결과 |
|---|---|---|---|---|
| INV × DDG → DATA (H6.1) | 0.331*** | -0.077 | 0.277 | 기각 |
| DATA × DDG → IPO (H6.2) | 0.393*** | 0.024 | 0.698 | 기각 |
| IPO × DDG → ER (H6.3) | 0.232** | -0.024 | 0.699 | 기각 |
주) *p < .05, **p < .01, ***p < .001
반면, DDG의 주효과는 모든 모형에서 유의한 것으로 나타났다. 구체적으로 DDG는 DATA(B=0.331, p<.001), IPO(B=0.393, p<.001), 그리고 ER(B=0.232, p<.01)에 각각 유의한 정(+)의 영향을 미치는 것으로 확인되었다. 이는 분산형 데이터 거버넌스 수준이 높을수록 데이터 운영역량, 기업 간 프로세스 최적화 및 생태계 대응성이 향상될 수 있음을 시사한다.
그러나 DDG와 각 독립변수 간 상호작용항은 모두 통계적으로 유의하지 않은 것으로 나타나, 분산형 데이터 거버넌스는 AI-Web3 투자 포트폴리오가 데이터 운영역량으로 전이되는 과정, 데이터 운영역량이 기업 간 프로세스 최적화로 연결되는 과정, 그리고 기업 간 프로세스 최적화가 생태계 대응성으로 이어지는 과정을 강화하거나 약화시키는 조절효과를 제공하지 않는 것으로 확인되었다. 따라서 H6.1, H6.2 및 H6.3은 모두 기각되었다.
Ⅵ. 결 론
6.1 학술적․실무적 시사점
학술적 관점에서 본 연구는 다음과 같은 이론적 시사점을 제공한다. 첫째, 본 연구는 AI와 Web3를 통합한 디지털 투자자원이 어떠한 과정을 거쳐 생태계 수준의 성과로 전환되는지를 설명하는 가치 전환 메커니즘을 실증적으로 규명하였다. 선행연구는 AI, 빅데이터 분석, 블록체인 등 디지털 기술이 공급망 운영성과와 회복탄력성을 향상시키며, 그 효과가 동태적 역량과 운영 역량을 통해 실현된다고 보고하였다(Belhadi et al., 2024; Dubey et al., 2019; Mikalef et al., 2020; Wamba et al., 2017). 또한 디지털 전환이 공급망 역량을 강화하고 경쟁우위와 환경변화 대응능력을 제고한다는 점도 제시되어 왔다(Ning and Yao, 2023). 그러나 기존 연구는 개별 기술의 효과나 디지털 역량 자체에 초점을 두어, 디지털 투자자원이 실제 운영 성과로 전환되는 과정에 대해서는 충분한 설명을 제공하지 못하였다.
이에 본 연구는 AI-Web3 투자 포트폴리오를 선행요인으로 설정하고, 데이터 운영역량과 기업 간 프로세스 최적화를 거쳐 생태계 대응성으로 이어지는 순차적 전환 메커니즘을 실증적으로 검증하였다. 분석 결과, AI-Web3 투자 포트폴리오는 생태계 대응성에 직접적인 영향을 미칠 뿐 아니라 데이터 운영역량과 기업 간 프로세스 최적화를 통해 간접적으로도 영향을 미쳤으며, 총효과의 약 46.5%가 간접효과를 통해 설명되었다. 이는 디지털 기술 투자의 성과가 단순한 기술 보유가 아니라 역량 구축과 운영 실행을 거쳐 실현되는 전환 과정임을 보여주며, AI 기반 공급망 전환 연구에 역량전환(Capability Conversion) 관점을 제시하였다는 점에서 학술적 의의가 있다.
둘째, 본 연구는 공급망을 상호 연결된 기업들의 생태계로 바라보는 기존 관점을 확장하여, 생태계 대응성(ecosystem responsiveness)의 형성 메커니즘을 실증적으로 제시하였다. 선행연구는 공급망 통합과 디지털 연계가 운영 효율성과 기업 성과를 향상시키는 핵심 요인임을 강조하였으며(Flynn et al., 2010; Rai et al., 2006; Schoenherr and Swink, 2012), 최근에는 동태적 역량 관점에서 공급망의 적응성과 회복탄력성에 대한 논의도 확대되고 있다(Roh and Xiao, 2024). 그러나 기존 연구는 공급망 참여자 간 연결성과 협업의 효과를 주로 기업 수준의 운영성과나 조직역량 중심에서 설명해 왔으며, 생태계 차원의 공동 대응역량을 하나의 개념으로 정의하고, 그 형성 과정을 실증적으로 규명한 연구는 제한적이었다.
이에 본 연구는 생태계 대응성을 개별 기업의 대응능력이 아니라 참여자 간 데이터 공유, 기업 간 프로세스 최적화 및 협업적 실행을 통해 형성되는 생태계 수준의 공동 대응역량으로 개념화하고, 그 형성 메커니즘을 실증적으로 검증하였다. 이를 통해 기존 공급망 생태계 연구를 네트워크 구조와 연결성 중심의 논의에서 나아가, 데이터 기반 협업과 공동 실행을 통해 생태계 대응역량이 형성되는 과정까지 설명하는 방향으로 확장하였다. 이러한 점에서 공급망 생태계 연구의 이론적 범위를 확장하고, 생태계 수준의 대응 메커니즘을 설명하는 새로운 관점을 제시하였다는 학술적 의의가 있다.
셋째, 본 연구는 분산형 데이터 거버넌스의 역할에 대한 기존 이론을 재해석할 수 있는 실증적 근거를 제시하였다. 선행연구는 블록체인 및 Web3 기반 거버넌스가 조직 간 신뢰, 투명성 및 데이터 공유를 촉진함으로써 협업 성과와 공급망 운영의 효율성을 향상시킬 수 있음을 제시해 왔다(Beck et al., 2018; Saberi et al., 2019; Treiblmaier, 2018). 이러한 논의를 바탕으로 분산형 데이터 거버넌스는 디지털 투자와 운영역량 간의 관계를 강화하는 조절기제로 기능할 것으로 예상되어 왔다.
그러나 본 연구에서는 세 개의 경로 모두에서 조절효과가 유의하지 않은 반면, 데이터 운영역량, 기업 간 프로세스 최적화 및 생태계 대응성에 대한 직접효과는 모두 유의하게 나타났다. 이러한 결과는 분산형 데이터 거버넌스를 특정 관계의 효과를 증폭시키는 조절기제로 이해하기보다, 조직 간 데이터 공유와 협업이 이루어질 수 있는 신뢰 기반의 제도적․기술적 환경으로 이해할 필요가 있음을 시사한다. 즉, 분산형 데이터 거버넌스의 이론적 가치는 특정 경로의 효과를 강화하는 데 있기보다, 데이터 활용과 기업 간 협업이 가능하도록 지원하는 기반 조건(enabling condition)을 제공하는 데 있을 수 있다. 이러한 결과는 Web3 기반 거버넌스의 역할을 기존의 조절 메커니즘 중심에서 디지털 협업의 기반 환경으로 확장하여 해석할 수 있는 가능성을 제시한다.
실무적 관점에서 본 연구 결과는 기업의 디지털 전환 전략 수립에 중요한 시사점을 제공한다. 첫째, 기업의 공급망 전환 전략은 AI 및 Web3 기술에 대한 투자 자체보다 이를 실제 운영 프로세스에 내재화하는 데 초점을 둘 필요가 있다. 본 연구에서는 AI-Web3 투자 포트폴리오의 효과 상당 부분이 데이터 운영역량과 기업 간 프로세스 최적화를 통한 간접경로에서 발생하는 것으로 나타났다. 이는 디지털 기술 도입만으로는 충분하지 않으며, 이를 데이터 기반 의사결정과 기업 간 협업 프로세스 혁신으로 연결할 수 있는 실행체계 구축이 중요함을 의미한다. 실무적으로 이는 AI 시대의 경쟁우위가 단순한 기술 도입 자체가 아니라 데이터를 실행 가능한 운영 성과로 전환하는 능력에 달려 있음을 시사한다. 또한 복잡성과 불확실성이 증가하는 글로벌 공급망 환경에서는 기업 간 협업과 조정 역량이 지속가능한 경쟁우위의 핵심 요소가 될 수 있다.
둘째, 분산형 데이터 거버넌스는 단기적인 성과 향상 수단이 아니라 디지털 협업을 가능하게 하는 기반 인프라로 구축할 필요가 있다. 본 연구에서는 분산형 데이터 거버넌스의 조절효과는 유의하지 않았으나 데이터 운영역량, 기업 간 프로세스 최적화 및 생태계 대응성에 대한 직접효과는 모두 유의하게 나타났다. 이는 기업이 분산형 데이터 거버넌스를 개별 역량의 효과를 증폭시키기 위한 수단으로 접근하기보다, 데이터의 신뢰성과 공유 체계를 확보하고 조직 간 협업이 안정적으로 이루어질 수 있도록 지원하는 디지털 기반으로 구축할 필요가 있음을 시사한다. 특히 개방형 공급망 생태계에서는 데이터 신뢰성 확보와 표준화된 정보 연계 체계를 우선적으로 구축하고, 이를 토대로 데이터 운영역량과 기업 간 프로세스 최적화를 강화하는 전략이 보다 효과적일 수 있다.
6.2 연구의 한계 및 향후 연구방향
본 연구는 다음과 같은 한계를 지니며, 이를 바탕으로 향후 연구방향을 제시하고자 한다. 첫째, 본 연구는 개방형 생태계(Open Ecosystem) 환경에서 외부 파트너와 데이터 공유 및 협업을 수행하는 기업을 대상으로 분석을 수행하였다. 기업 수준에서는 외부 조직과의 데이터 연계 및 협업 경험이 없는 기업을 조사 대상에서 제외하였는데, 이는 본 연구가 생태계 대응성(ER)을 기업 간 데이터 공유와 협업을 기반으로 형성되는 역량으로 정의하고 있기 때문이다. 따라서 본 연구의 결과를 폐쇄형 운영체계 또는 독립적으로 운영되는 조직 환경에 일반화하는 데에는 한계가 있다. 따라서 향후 연구에서는 개방형 생태계와 폐쇄형 운영환경을 비교하거나, 데이터 공유 수준과 협업 범위에 따른 차이를 분석함으로써 AI 기반 공급망 전환 효과의 적용 범위를 보다 폭넓게 검증할 필요가 있다.
둘째, 본 연구는 AI와 Web3를 포괄하는 통합적 투자 포트폴리오 개념을 이론적 기반으로 연구모형을 설계하였다. 그러나 측정모형 검증 결과, Web3 관련 문항은 독립적인 구성개념으로 충분한 수렴성을 확보하지 못하였다. 이는 본 연구에서 제시한 AI-Web3 투자 포트폴리오의 이론적 개념이 현 시점의 실증자료에서는 부분적으로만 구현되었음을 의미하며, Web3 기술의 고유한 효과를 충분히 검증하지 못한 한계가 있다. 이러한 결과는 국내 기업의 Web3 기술 도입과 활용이 아직 초기 단계에 머물러 있거나, Web3가 독립적인 투자영역보다는 AI 및 데이터 활용을 지원하는 기반 인프라로 인식되고 있기 때문일 가능성을 시사한다. 따라서 향후 연구에서는 AI 투자와 Web3 투자를 구분하여 측정하거나, 블록체인, 스마트계약, 분산형 신원인증(DID) 등 Web3의 세부 구성요소를 독립적인 구성개념으로 측정함으로써 Web3 기술의 고유한 가치와 AI와의 상호보완적 역할을 보다 정교하게 검증할 필요가 있다.
셋째, 본 연구에서는 분산형 데이터 거버넌스를 조절변수로 설정하였으나 세 개의 경로 모두에서 조절효과가 유의하지 않은 것으로 나타났다. 이러한 결과는 분산형 데이터 거버넌스의 역할이 본 연구에서 가정한 조절효과와는 다른 방식으로 작동할 가능성을 시사하지만, 본 연구의 정량적 분석만으로 그 작동 메커니즘을 충분히 설명하기에는 한계가 있다. 특히 현재 산업 현장에서 Web3 기반 거버넌스의 도입 수준이 아직 초기 단계에 머물러 있어 그 효과가 충분히 발현되지 않았을 가능성도 배제하기 어렵다. 따라서 향후 연구에서는 사례연구나 심층 인터뷰 등 질적 연구방법을 병행하여 분산형 데이터 거버넌스가 실제 조직 간 데이터 공유와 협업 과정에서 어떠한 역할을 수행하는지를 보다 구체적으로 규명할 필요가 있다. 또한 분산형 데이터 거버넌스를 조절변수뿐 아니라 선행요인 또는 매개변수로 재구성하고, 산업별․공급망 네트워크별 비교연구를 통해 그 작동 메커니즘과 적용 조건을 보다 정교하게 검증할 필요가 있다.
마지막으로, 본 연구는 생태계 대응성을 대응 속도, 협업적 문제 해결, 적응 및 재구성, 회복탄력성을 포괄하는 생태계 차원의 동태적 역량으로 개념화하여 분석하였다. 이러한 접근은 환경 변화에 대한 공동 대응 메커니즘을 통합적으로 설명할 수 있다는 장점이 있으나, 각 하위 차원의 상대적 영향력이나 계층적 구조를 충분히 검증하지는 못하였다. 특히 본 연구에서는 생태계 대응성을 하나의 구성개념으로 측정하였으나, 향후 연구에서는 대응 속도, 적응성 및 회복탄력성 등을 1차 요인으로 하고 생태계 대응성을 2차 요인(second-order construct)으로 설정하여 구성개념의 계층적 구조와 차원별 역할을 보다 정교하게 검증할 필요가 있다.